Привет! В этой статье я бы хотел рассказать как я сделал распознавалку русских букв и прикрутил к этому небольшой графический интерфейс.
Спойлер: в результате должно получиться вот так:
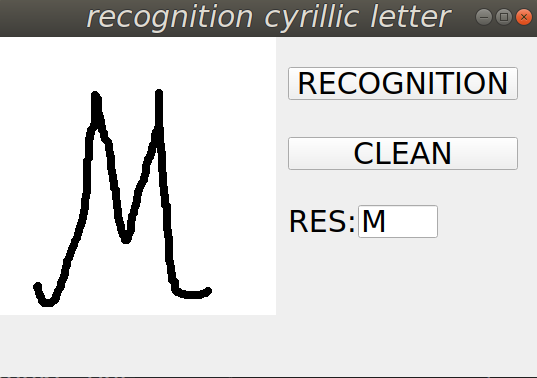
Привет! В этой статье я бы хотел рассказать как я сделал распознавалку русских букв и прикрутил к этому небольшой графический интерфейс.
Спойлер: в результате должно получиться вот так:
Привет!
Сегодня мы затрагиваем актуальнейшую тему — Python для работы с GPU. Автор рассматривает пример, тривиальный в своей монструозности, и демонстрирует решение, сопровождая его обширными листингами. Приятного чтения!

Django ORM (Object Relational Mapping) является одной из самых мощных особенностей Django. Это позволяет нам взаимодействовать с базой данных, используя код Python, а не SQL.
Для демонстрации опишу такую модель:
from django.db import models

class Blog(models.Model):
    name = models.CharField(max_length=250)
    url = models.URLField()

    def __str__(self):
        return self.name

class Author(models.Model):
    name = models.CharField(max_length=250)

    def __str__(self):
        return self.name

class Post(models.Model):
    title = models.CharField(max_length=250)
    content = models.TextField()
    published = models.BooleanField(default=True)
    blog = models.ForeignKey(Blog, on_delete=models.CASCADE)
    authors = models.ManyToManyField(Author, related_name="posts")

Продолжаю публикацию решений отправленных на дорешивание машин с площадки HackTheBox.
В данной статье собираем много много pwn, которые будем решать средствами pwntools. Думаю будет полезно читателям с любым уровнем осведомленности в данной теме. Поехали…
Подключение к лаборатории осуществляется через VPN. Рекомендуется не подключаться с рабочего компьютера или с хоста, где имеются важные для вас данные, так как Вы попадаете в частную сеть с людьми, которые что-то да умеют в области ИБ :)
Сегодня появляется все больше 3D датасетов и задач, связанных с 3D данными. Это связано с развитием робототехники и машинного зрения, технологий виртуальной и дополненной реальности, технологий медицинского и промышленного сканирования. Алгоритмы машинного обучения помогают решать сложные задачи, в которых необходимо классифицировать трехмерные объекты, восстанавливать недостающую информацию о таких объектах, или же порождать новые. Несмотря на достигнутые успехи, в области 3D ML остаются нерешенными еще очень много задач, и эта серия заметок призвана популяризировать направление среди русскоязычного сообщества.
В первой части будут рассмотрены основные формы и форматы представления пространственных данных и их особенности.
Статей с подобными заголовками существует уже множество. Но в них постоянно какая-то дичь! Смотрите, Google ещё до основных результатов советует такое:
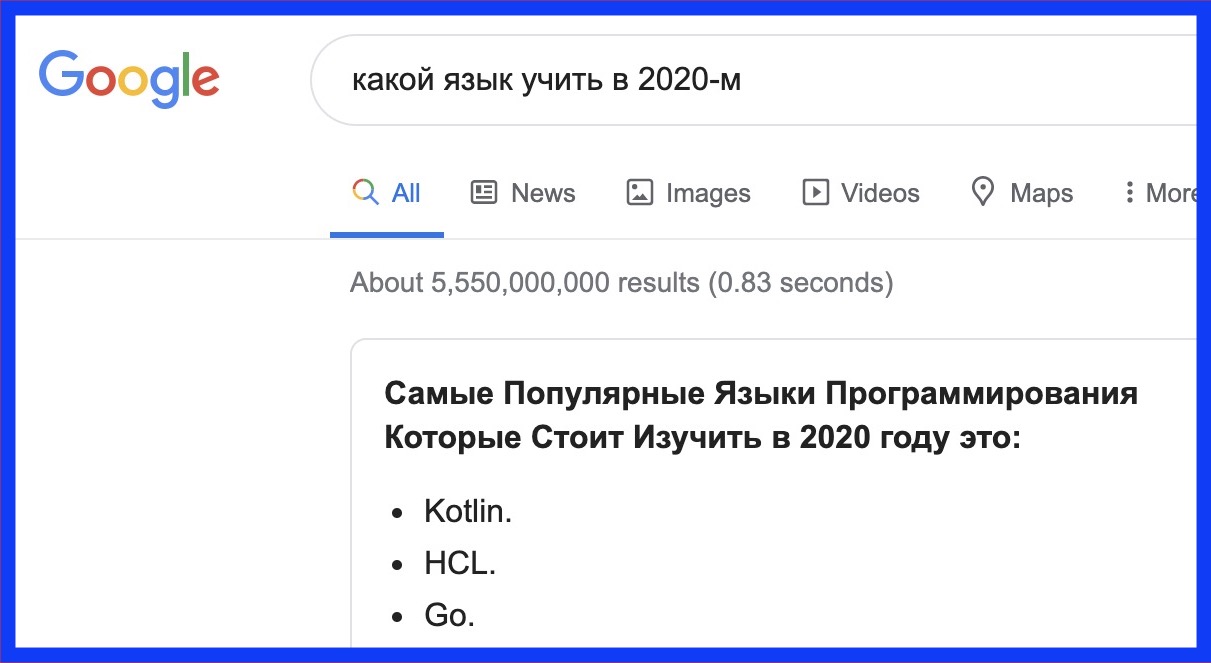
HCL, Карл! Язык, который не просто очень далёк от «Самых Популярных», но ещё и создан для конфигурации, так что его вообще странно ставить в один ряд с языками общего назначения. Страшно представить приключения новичка, который решит строить карьеру по таким советам. Начнём с того, что по запросу «как выучить HCL» вместо туториалов по языку вылезают тексты о соляной кислоте.
Это только одна из многих дикостей, которые я встретил в подобных текстах. Поэтому захотелось объяснить, что с ними не так — и написать собственный текст получше, ссылку на который можно кидать начинающим. Конечно, аудитории Хабра информация для начинающих не очень требуется, зато читатели могут дополнить текст в комментариях, сделав его ещё полезнее.
Всем привет, меня зовут Фёдор Индукаев, я работаю аналитиком в Яндекс.Маршрутизации. Сегодня хочу рассказать вам про задачу визуализации пересекающихся множеств и про пакет для Python с открытым кодом, созданный мной для её решения. В процессе мы узнаем, чем различаются диаграммы Венна и Эйлера, познакомимся с сервисом распределения заказов и по касательной заденем такую область науки, как биоинформатика. Двигаться будем от простого к более сложному. Поехали!

Мы в компании создаем сервис, который позволяет автоматически создавать, управлять и безопасно хранить лицензионные соглашения и прочие договоры между фрилансерами и их клиентами.
Для решения это задачи я опробовал десятки решений в области обработки естественного языка, в том числе решения с открытым кодом и хотел бы поделиться опытом работы с open source Python — библиотеками для распознавания именованных сущностей.
Несколько слов о самой проблеме. Named Entity Recognition (NER) — это направление технологии обработки человеческого языка, программная реализация которой позволяет находить в речи и тексте опредмеченные категории слов и словосочетаний. Сначала это были географические наименования, имена людей, организаций, адреса, однако в настоящее время это понятие сильной расширилось и с помощью NER мы ищем в тексте относительные и абсолютные даты, числа, номера и т.д.
Выявление именованных сущностей — это «ворота» в человеческий язык, оно позволяет выявлять и обрабатывать намерения человека, устанавливать связи слов в его речи и реальным миром.
Продолжаю публикацию решений отправленных на дорешивание машин с площадки HackTheBox.
В данной статье эксплуатируем XXE в сервисе преобразования DOCX документов в PDF, получаем RCE через LFI, копаемся в истории GIT и восстанавливаем файлы, составляем ROP цепочки с помощью pwntools и находим спрятанный файл рута.
Подключение к лаборатории осуществляется через VPN. Рекомендуется не подключаться с рабочего компьютера или с хоста, где имеются важные для вас данные, так как Вы попадаете в частную сеть с людьми, которые что-то да умеют в области ИБ :)
Новая версия ожидается только в октябре, но уже можно почитать, что нас ждет в ней и потестить предварительный релиз.
В этой статье самые интересные, на мой взгляд, изменения.
Во-первых, нам напоминают, что слои, поддерживающие обратную совместимость с версией 2.7, потихоньку удаляют и просят обратить внимание на DeprecationWarning и устранить их. Несколько предупреждений еще останутся в 3.9, но лучше избавляться и от них.
Читать полностью »