Рубрика «machine learning» - 13

Бывает листаешь книгу или журнал, видишь красивое место или здание, но не знаешь, где оно и как называется. Тут пригодилось бы приложение, которое распознает его по фотографии.

С помощью машинного обучения создать такое приложение довольно просто. Об этом и пойдет речь в этой статье.

О распознавании достопримечательностей

Читать полностью »

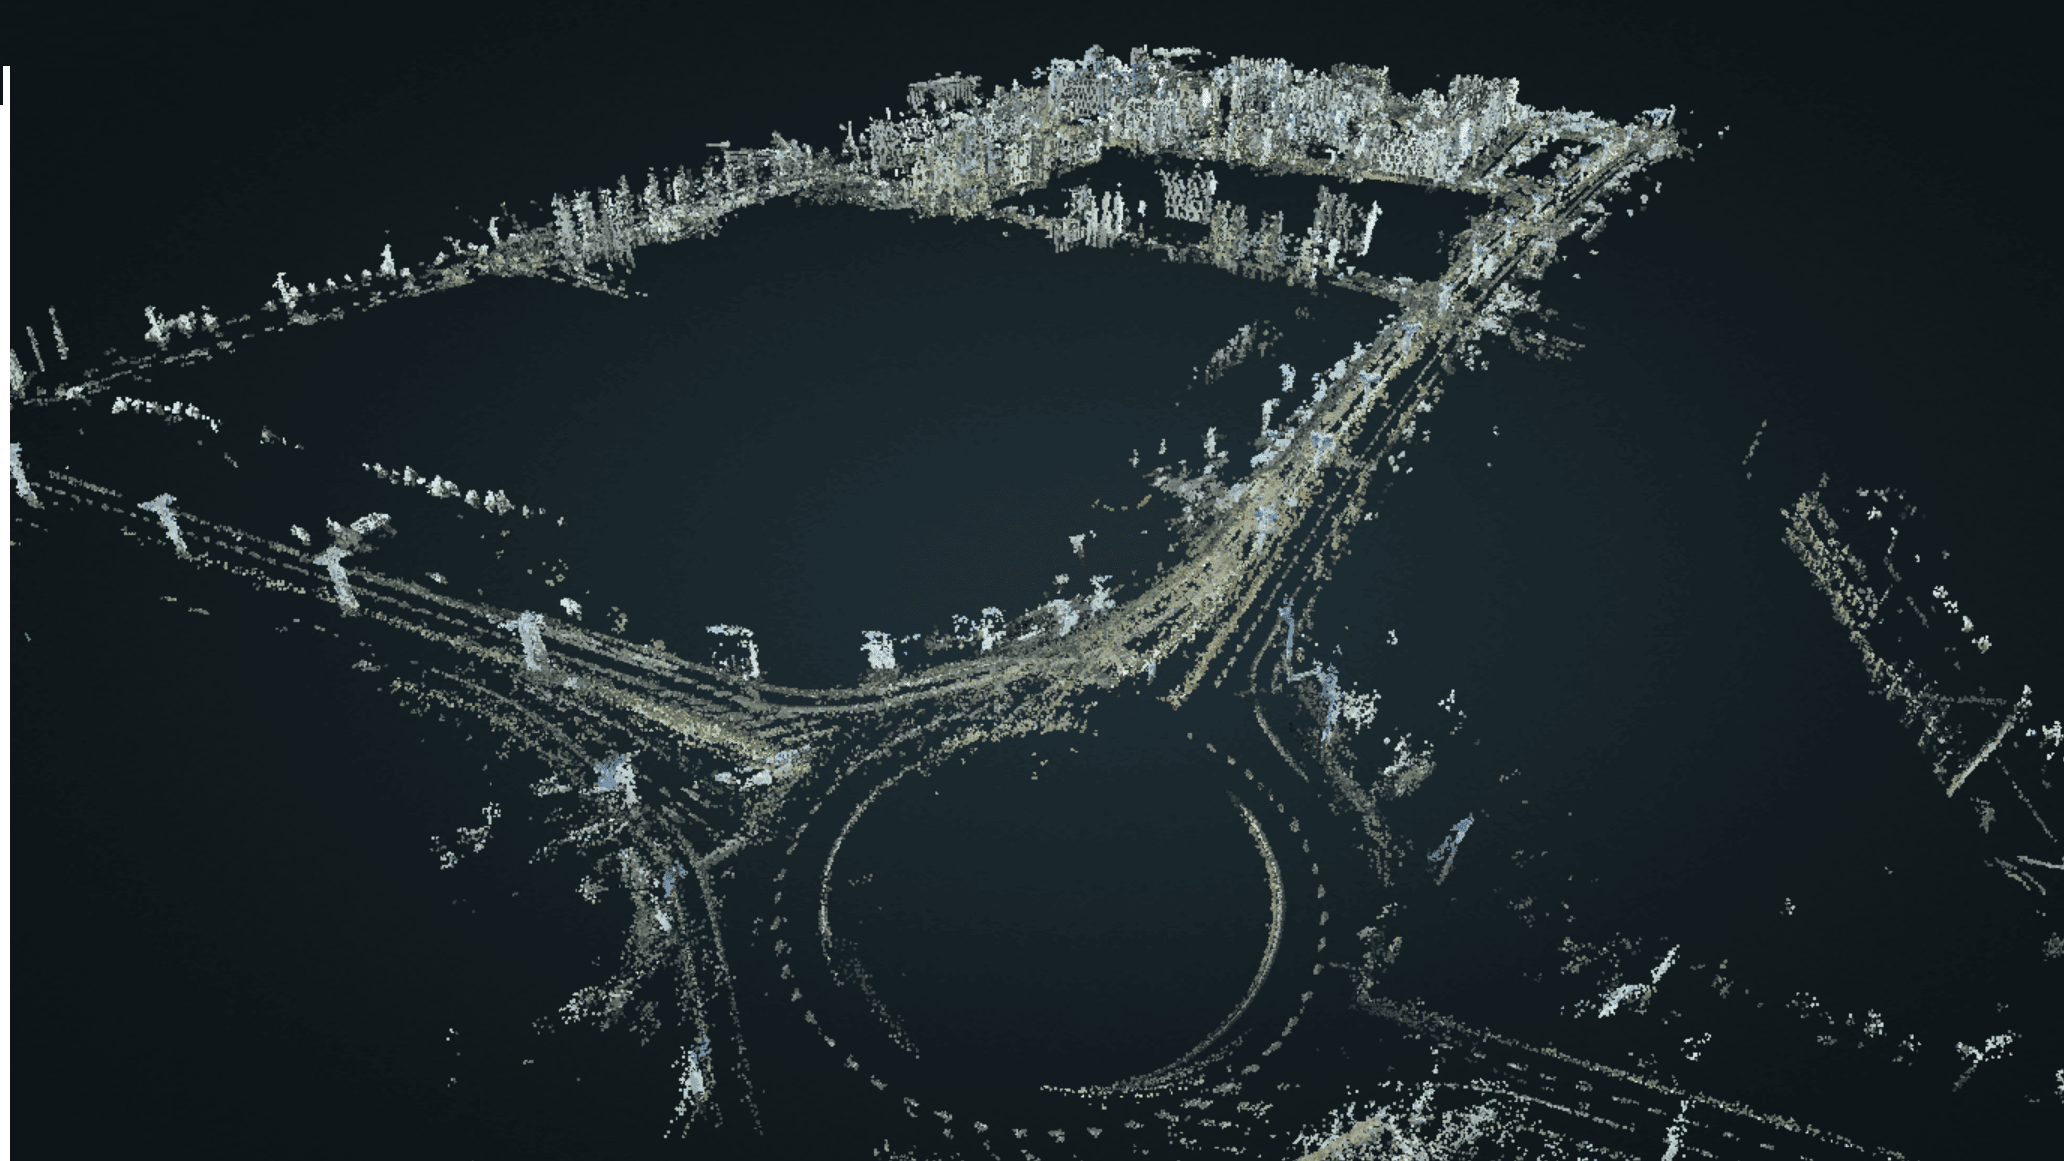
Визуальный SLAM: делаем HD-карты при помощи смартфона - 1

Привет! Меня зовут Александр Гращенков, я iOS-разработчик в компании RoadAR. С 2016 года живу и работаю в Иннополисе, занимаюсь компьютерным зрением и интеграцией нейросетей в мобильные платформы.

Читать полностью »

Привет! Меня зовут Александр, я работаю в команде матчинга Ozon. Ежедневно мы имеем дело с десятками миллионов товаров, и наша задача — поиск и сопоставление одинаковых предложений (нахождение матчей) на нашей площадке, чтобы вы не видели бесконечную ленту одинаковых товаров.
На странице любого товара на Ozon есть картинки, заголовок, описание и дополнительные атрибуты. Всю эту информацию мы хотим извлекать и обрабатывать для решения разных задач. И особенно она важна для команды матчинга. 
Чтобы извлекать признаки из товара, мы строим его векторные представления (эмбеддинги), используя различные текстовые модели (fastText, трансформеры) для описаний и заголовков и целый набор архитектур свёрточных сетей (ResNet, Effnet, NFNet) — для картинок. Далее эти векторы используются для генерации фичей и товарного сопоставления.
На Ozon ежедневно появляются миллионы обновлений — и считать эмбеддинги для всех моделей становится проблематично. А что, если вместо этого (где каждый вектор описывает отдельную часть товара) мы получим один вектор для всего товара сразу? Звучит неплохо, только как бы это грамотно реализовать…
Векторное представление товаров Prod2Vec: как мы улучшили матчинг и избавились от кучи эмбеддингов - 1
Читать полностью »

Кластеризация изображений с помощью нейросети CLIP - 1

В статье пойдёт речь о том, как можно автоматически разделить датасет изображений на кластеры, которые поделены по качественному контекстному признаку, благодаря эмбедингам из нашумевшей нейронной сети CLIP от компании Илона Маска. Расскажу на примере контента из нашего приложения iFunny.

Читать полностью »

Первое правило машинного обучения: начните без машинного обучения - 1

Эффективное использование машинного обучения — сложная задача. Вам нужны данные. Вам нужен надёжный конвейер, поддерживающий потоки данных. И больше всего вам нужна высококачественная разметка. Поэтому чаще всего первая итерация моих проектов вообще не использует машинное обучение.

Что? Начинать без машинного обучения?

Об этом говорю не только я.

Догадайтесь, какое правило является первым в 43 правилах машинного обучения Google?

Правило №1: не бойтесь запускать продукт без машинного обучения.

Машинное обучение — это здорово, но для него требуются данные. Теоретически, можно взять данные из другой задачи и подстроить модель под новый продукт, но она, скорее всего, не справится с базовыми эвристиками. Если вы предполагаете, что машинное обучение придаст вам рост на 100%, то эвристика даст вам 50%.

Читать полностью »

Разбираем редкого зверя от Nvidia — DGX A100 - 1

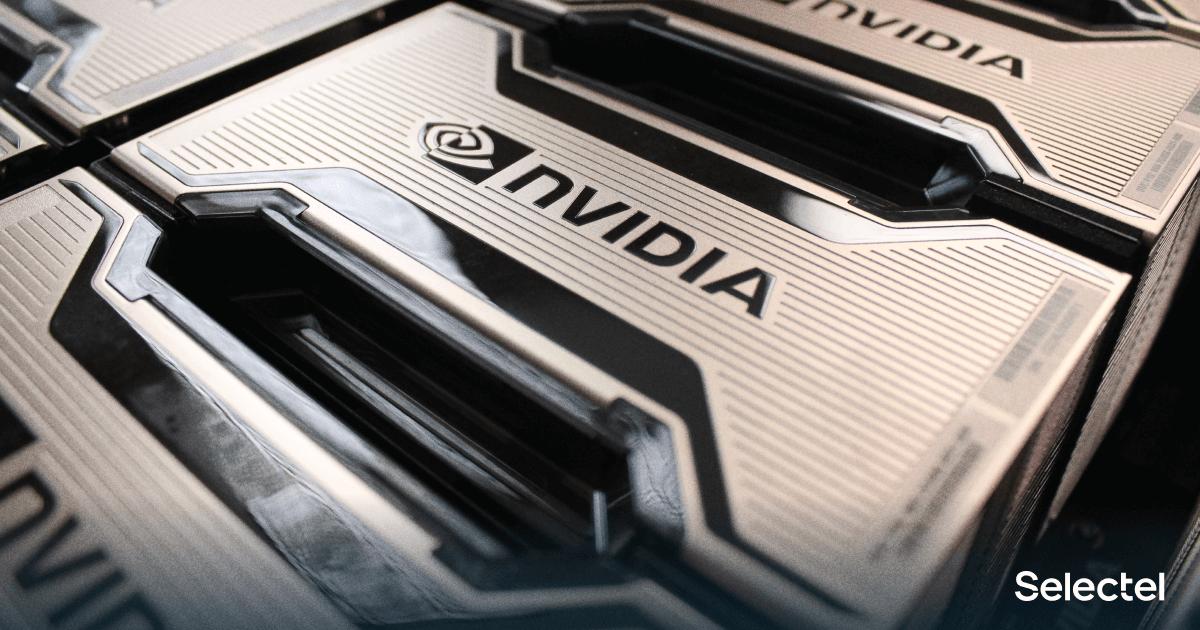
Крупные IT-компании располагают дорогими «игрушками», которые скрыты от взоров большинства пользователей. Сегодня мы приоткроем завесу тайны и расскажем про систему, которая оптимизирована для работы с искусственным интеллектом.

Задачи ИИ предъявляют высокие требования к вычислительным и сетевым ресурсам, поэтому наш сегодняшний «гость» приятно порадует своей конфигурацией. Встречайте: NVIDIA DGX A100.
Читать полностью »

Как классифицировать данные без разметки - 1

Пользователи iFunny ежедневно загружают в приложение около 100 000 единиц контента, среди которого не только мемы, но и расизм, насилие, порнография и другие недопустимые вещи.

Читать полностью »

Закройте глаза и представьте себя в цехах большого завода. Пусть это будет производство вакцин в ампулах. А вы, как и еще 70 человек, заняты тем, что целыми днями просматриваете ампулы, чтобы отобрать дефектные. И так весь день… Сколько ампул с малейшими отклонениями от нормы вы бы не заметили? Задачу усложняет то, что дефектом считается не только неправильная запайка, но и едва заметная точка на дне ампулы. Можете ли вы быть на 100% уверены, что не пропустили ни одного дефекта? А ведь вас еще будут выборочно перепроверять.

Устают глаза, притупляется внимание.

Читать полностью »

В июле исследователи Google из команды Brain Team поделились своими достижениями в области масштабирования изображений. Результаты своих исследований они опубликовали в блоге Google AI, посвящённом исследованиям и разработкам в области машинного обучения и искусственного интеллекта.

В статье под названием «Создание высокоточных изображений с использованием диффузионных моделей» (High Fidelity Image Generation Using Diffusion Models) продемонстрирована технология масштабирования изображений на базе диффузионных моделей.

Читать полностью »


https://ajax.googleapis.com/ajax/libs/jquery/3.4.1/jquery.min.js