
На первый взгляд нижеприведённый материал может показаться ещё одним банальным «хэллоууорлдом», «туториалом от Капитана Очевидность», коих уже предостаточно на просторах Сети, но это впечатление обманчиво. На деле чтобы добиться того же результата с нуля у WinForms-программиста, не работавшего ранее с Entity Framework Core (не путать с классической Entity Framework) и вооружённого только уже валяющимися в изобилии на просторах Сети туториалами по EF Core и документацией может уйти куда больше времени, чем он наивно ожидал до того, как взялся за дело. Так случилось и со мной. Посему хочу поделиться опытом.
Читать полностью »
Рубрика «sqlite» - 11
Использование Entity Framework Core code-first с СУБД SQLite при разработке WinForms-приложений в VisualStudio 2015
2017-03-18 в 14:09, admin, рубрики: .net, .net frameowrk, entity framework core, sqlite, Visual Studio, visual studio 2015, WinForms, десктоп, метки: entity framework corePython: Работа с базой данных, часть 1-2: Используем DB-API
2017-02-14 в 20:23, admin, рубрики: db, db-api, python, sql, sqlite, ПрограммированиеPython DB-API – это не конкретная библиотека, а набор правил, которым подчиняются отдельные модули, реализующие работу с конкретными базами данных. Отдельные нюансы реализации для разных баз могут отличаться, но общие принципы позволяют использовать один и тот же подход при работе с разными базами данных.
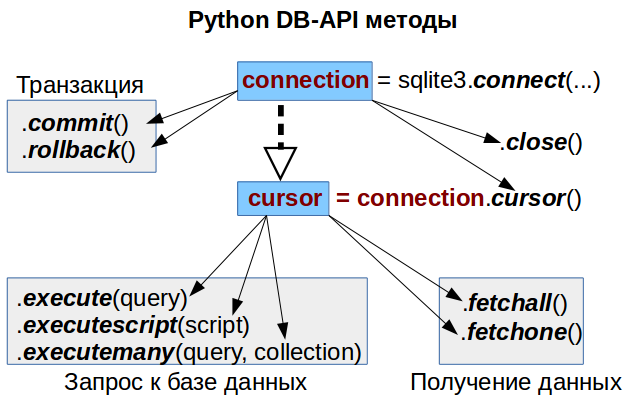
В статье рассмотрены основные методы DB-API, позволяющие полноценно работать с базой данных. Полный список можете найти по ссылкам в конец статьи.
Требуемый уровень подготовки: базовое понимание синтаксиса SQL и Python.
Читать полностью »
Всем привет. Пишу на Хабре впервые, не судите строго. Хочу поделиться своим опытом поиска универсальной SQLite ORM библиотеки на С++ и моей новой разработкой собственной библиотеки для работы с SQLite на C++ sqlite_orm.
Когда я искал ORM'ку я отталкивался от нескольких ключевых пунктов:
- библиотека должна иметь как CRUD, так и не CRUD
- должны быть гибкие условия WHERE, а не тупо
WHERE id = ? - должен быть функционал миграций (синхронизации схемы) на случай обновлений приложения
- фичи вроде ORDER BY и LIMIT тоже должны быть
- сериализация классов не должна быть написана в своих классах. Это очень важный пункт для меня с тех пор, как я познакомился с Java и с Android-разработкой в частности. Android-разработчики стараются придерживаться принципа единственной ответственной (single responsibility principle), что очень важно если приложение собрано из разной кучи библиотек и модулей, которые могут меняться с течением времени. И поэтому самая популярная на github SQLite ORM'ка на С++ hiberlite меня не устроила способом сериализации — класс модели должен иметь статичную функцию
serializeс кодом непосредственной сериализации. Я искал такой модуль, от которого бы не зависел код моей модели данных. Ведь у меня может быть несколько сериализаторов (JSON, XML, SQLite), и по-хорошему каждый должен прилагаться к модели данных, но никак ее не менять, а иначе получится каша в коде модели.
Читать полностью »
Генерация фиктивных данных с Elizabeth: Часть II
2017-01-18 в 15:59, admin, рубрики: db, django, dummy, fake, python, sqlite, testing, данные, тест, фейк, фиктивные
Ранее я уже публиковал статью о том, как генерировать фиктивные данные при помощи Elizabeth — библиотеки для языка программирования Python. Статья, которую вы читаете является продолжением предыдущей, потому я не буду приводить основ работы с библиотекой. Если вы пропустили статью, поленились прочитать или просто не захотели, то, вероятно, захотите сейчас, ибо эта статья подразумевает, что читатель уже знаком с основами библиотеки. В этой части статьи я буду говорить о том, каким образом организовывать генерацию фиктивных данных в собственных приложениях, расскажу о нескольких, на мой взгляд, полезных особенностях библиотеки.
Разработка для Sailfish OS: работа с LocalStorage
2016-12-13 в 7:44, admin, рубрики: QML, qt, sailfish os, sqlite, мобильная разработка, разработка мобильных приложенийЗдравствуйте! Данная статья является продолжением цикла статей, посвященных разработке для мобильной платформы Sailfish OS. В этот раз мы решили рассказать о приложении для контроля финансов, позволяющее пользователю вести журнал доходов и расходов, а также откладывать средства для осуществления целей. Стоит упомянуть, что данное приложение является одним из победителей хакатона по Sailfish OS в Ярославле, организованного компанией «Открытая Мобильная Платформа» и ассоциацией FRUCT.
Читать полностью »
ASP.NET Core: Пример реализации шаблонов проектирования Единица работы и Репозиторий
2016-10-12 в 13:13, admin, рубрики: .net, ASP, ASP.NET, asp.net core, microsoft, open source, sqlite, Visual Studio, Блог компании Microsoft, веб-службы, руководство, руководство для разработчикаВ этой статье мы поговорим о шаблонах проектирования «Единица работы» и «Репозиторий» в контексте тестового веб-приложения на ASP.NET Core (с использованием встроенного DI), которое мы с вами вместе и разработаем. В результате мы получим две реализации взаимодействия с хранилищем: настоящую, на основе базы данных SQLite, и фейковую, для быстрого тестирования, на основе перечисления в памяти. Переключение между этими двумя реализациями будет выполняться изменением одной строчки кода.

Scrapy: собираем данные и сохраняем в базу данных
2016-08-28 в 7:54, admin, рубрики: python, scrapy, sqlalchemy, sqlite, парсинг, метки: ScrapyВведение
Меня заинтересовал данный фреймворк для сбора информации с сайтов. Здесь были публикации по Scrapy, но поскольку детальной информации на русском языке мало, то я хотел бы рассказать о своем опыте.
Читать полностью »
Работа с БД в CleverStyle Framework
2016-08-22 в 7:35, admin, рубрики: cleverstyle, cmf, cms, DBAL, framework, mysql, php, postgresql, sql, sqlite, transactions, бд, Разработка веб-сайтов, транзакцииНа счёт БД на первый взгляд может показаться, что функциональность из коробки весьма скудная. Отчасти это правда, но компенсируется тем, арсенал очень хорошо продуман, решает поставленные задачи и ориентирован на производительность.
А если вам нужны более функциональные инструменты — их всегда можно до установить по вкусу, это гораздо проще чем выпилить сложного медлительного монстра.
Данная статья покажет основные интерфейсы, а трейты csCRUD и csCRUD_helpers останутся на другой раз.
Часть 1. Платформа СППР Универсальные алгоритмы
2016-07-31 в 19:55, admin, рубрики: Delphi, Firebird/Interbase, python, sqlite, Алгоритмы, графы, дизайнер, медицина, навигатор, системы поддержки принятие решений, служба поддержки, сппр, экспертные системыПриветствую, уважаемое сообщество!
Забегая вперед прошу прощения у тех, кто ожидает новизны или революционных идей. Их тут нет. Но есть вполне хорошая прикладная система.
Системы поддержки принятия решений сейчас набирают обороты. Причем я не буду особо останавливаться на перечислении способов реализации. Оговорюсь только об основных свойствах.
Я бы очень упрощенно и обобщенно назвал эти системы вероятностными. То есть они выдают рекомендации с известной долей вероятности используя накопленную и проанализированную статистику. Не скажу что это плохо. Тема BigData и Machine learning нынче в тренде. Так же эти системы работают по принципу черного ящика. Поэтому проверить достоверность работы заложенной модели не всегда можно выявить.Читать полностью »
Web scraping обновляющихся данных при помощи Node.js и PaaS
2016-07-05 в 7:08, admin, рубрики: data mining, javascript, morph.io, node.js, paas, scraping, sql, sqlite, web scraping, веб-скрейпинг, Программирование Это уже четвёртая статья в цикле про веб-скрейпинг при помощи Node.js:
- Web scraping при помощи Node.js
- Web scraping на Node.js и проблемные сайты
- Web scraping на Node.js и защита от ботов
- Web scraping обновляющихся данных при помощи Node.js
В прошлых статьях были рассмотрены получение и парсинг страниц, рекурсивный проход по ссылкам, организация и тонкая настройка очереди запросов, анализ Ajax-сайтов, обработка некоторых серверных ошибок, инициализация сессий и методы преодоления защиты от ботов.
В этой статье разбираются такие темы, как веб-скрейпинг регулярно обновляющихся данных, отслеживание изменений и использование облачных платформ для запуска скриптов и сохранения данных. Ещё внимание уделяется разделению задач веб-скрейпинга и обработки готовых данных, а также тому, чего стоит избегать при работе с обновляющимися сайтами.
Цель статьи – показать весь процесс создания, развёртывания и использования скрипта от постановки задачи и до получения конечного результата. Как обычно, для примера используется реальная задача, какие часто встречаются на биржах фриланса.