Рубрика «big data» - 43

Мы продолжаем серию интервью с выпускниками Newprolab, в которой они рассказывают о своей истории перехода в data science. Истории разные и будут интересны тем, кто задумывается о смене карьерной траектории или о том, как новые знания могут помочь решать в том числе текущие задачи. Недавно встретились с Яной Чаруйской, Product Owner в МТС. Яна рассказала, как она пришла в большие данные, как профессионально росла, вспомнила о своем любимом проекте, подарившем ей помимо знаний и опыта, еще и друзей. Рассказала о рабочей атмосфере в МТС, о проектах, которые делает ее команда, о своей мечте, планах на будущее и пр.

— Яна, расскажи немного о себе и своем бэкграунде.

— Меня зовут Яна Чаруйская, я Product Owner в МТС. Интересуюсь областью Big Data и занимаюсь ею уже порядка двух лет. Если вкратце про мою историю: я закончила ВШЭ по направлению «Бизнес-информатика», училась 6 лет, затем год училась на психолога. Четыре года я проработала в IT-консалтинге, три из них занималась хранилищами данных, витринами данных, построением управленческой отчетности в основном для крупных банков. Последний год в консалтинге занималась машинным обучением и предиктивной аналитикой. Сейчас я работаю в МТС менеджером по продукту, у меня команда из 6 человек, и она растет, в ближайшее время нанимаю еще 7. В целом, компания тоже расширяется, сейчас в МТС более 150 Big Data специалистов и еще открыто множество вакансий (планируем увеличить штат практически в 2 раза!). Мы с командой разрабатываем несколько продуктов одновременно, в настоящий момент они на разных стадиях реализации: есть продукты, которые находятся в стадии R&D, какие-то — в стадии продуктивизации.
Читать полностью »
Миграция данных в кровавом энтерпрайзе: что анализировать, чтобы не завалить проект - 1

Типичный проект системной интеграции для нас выглядит так: у заказчика вагон систем для учета клиентов, задача — собрать клиентские карточки в единую базу. И не только собрать, а еще очистить от дублей и мусора. Чтобы на выходе получились чистые, структурированные, полные карточки клиентов.

Для начинающих поясню, что миграция идет по такой схеме: источники → преобразование данных (отвечает ETL или шина) → приемник.

На одном проекте мы потеряли три месяца просто потому, что сторонняя команда интеграторов не изучала данные в системах-источниках. Самое обидное, что этого можно было избежать.
Читать полностью »

В ходе Российского-британского бизнес-форума, крупнейшего делового российского мероприятия в Лондоне, состоялась европейская премьера многопользовательской реабилитационной VR-платформы ATTILAN компании «Моторика». Система помогает людям научиться использовать протезы с постоянным онлайн-контролем этого процесса, что позволит обеспечить высокотехнологичной реабилитацией пациентов в любой точке мира.

image
Читать полностью »

Представьте, что вам надо вызвать такси. Вы открываете приложение, видите, что машина приедет минут через семь, нажимаете «Заказать» — и… автомобиль в 15 минутах от вас, если вообще найден. Согласитесь, неприятно?

Под катом поговорим о том, как методы машинного обучения помогают Яндекс.Такси более качественно прогнозировать ETA (Estimated Time of Arrival — ожидаемое время прибытия).

Чем поможет машинное обучение, когда каждая минута на счету. Прогнозируем ETA в Яндекс.Такси - 1
Читать полностью »

Мне давно хотелось изложить свои впечатления об Apache Spark, и тут как раз попалась на глаза вот эта статья от сотрудника Pivotal Robert Bennett: thenewstack.io/the-good-bad-and-ugly-apache-spark-for-data-science-work, опубликованная совсем недавно, 26 июня 2018.

Это не будет перевод, а скорее все-таки мои впечатления и комментарии на тему.
Читать полностью »

1. Анализ логов Check Point: официальное приложение Check Point для Splunk - 1

Работая с шлюзами безопасности компании Check Point, очень часто возникает задача разбора логов для обнаружения и анализа инцидентов информационной безопасности. Обычно в организациях существует уже какая-либо система логирования, и стоит задача транспортировки логов с сервера управления Check Point и последующая настройка фильтров для логов, составление дашбордов, графиков и так далее. В данном курсе мы рассмотрим различные варианты анализа логов Check Point с помощью внутреннего функционала и сторонних приложений, рассмотрим какую полезную информацию мы можем извлечь, и чем она поможет в настройке межсетевого экрана.
Читать полностью »

Мы продолжаем серию интервью с выпускниками Newprolab, в которой они рассказывают о своей истории перехода в область работы с большими данными. Истории разные и будут интересны тем, кто задумывается о смене карьерной траектории или о том, как новые знания могут помочь решать в том числе текущие задачи. Знакомьтесь — Олег Хомюк, Head of R&D в Lamoda.

Олег рассказал про свой карьерный путь, ценности, почему выбрал Lamoda, а не компанию в Долине, про текущие проекты, свою команду, про самый успешный и самый неудачный проекты, про отношение к data science и многое другое.

image
Читать полностью »

Пекин введёт социальный рейтинг для жителей города в 2020 году - 1
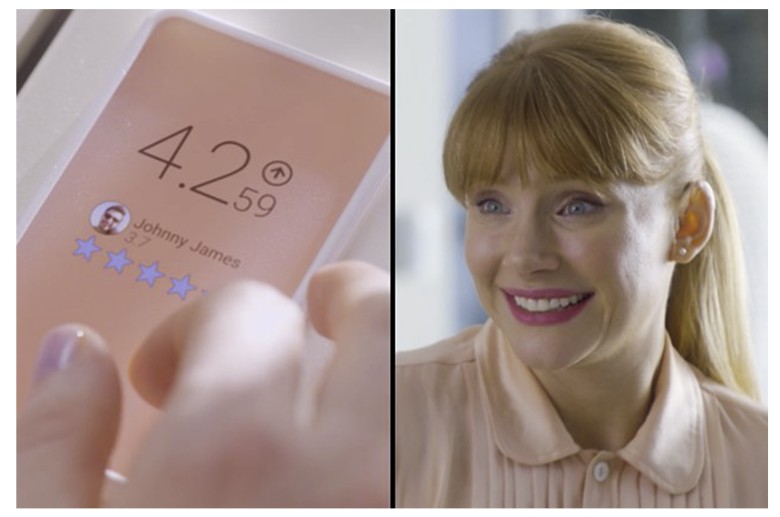
Система социального рейтинга в сериале «Чёрное зеркало»: сезон 3, эпизод 1

Власти Китая ранее заявляли о планах ввести социальный рейтинг для всех 1,3 миллиарда граждан страны в 2020 году. Очевидно, этим планам не суждено воплотиться в жизнь, и реализация программы в глобальном масштабе займёт гораздо больше времени. Тем не менее, киберпанковская система социального ранжирования граждан с компьютерным вычислением ценности каждого гражданина для общества в зависимости от его социального поведения становится всё ближе.

Недавно стало известно, что столица страны Пекин собирается внедрить программу пожизненных баллов до конца 2020 года. Каждому из 21,7 млн жителей мегаполиса будет присвоен социальный рейтинг. Официальный план 中共北京市委 北京市人民政府关于印发《北京市进一步优化营商环境行动计划(2018年—2020年)》的通知 опубликован 18 июля 2018 года на веб-сайте муниципального правительства Пекина.
Читать полностью »

Всем добрый день!

И у нас снова открыт новый поток на доработанный курса «Data scientist»: ещё один отличный преподаватель, чуть доработанная исходя из обновлений программа. Ну и как обычно интересные открытые уроки и подборки интересных материалов. Сегодня мы начнём разбор seq2seq моделей от Tensor Flow.

Поехали.

Как уже обсуждалось в туториале RNN (рекомендуем ознакомиться с ним перед чтением этой статьи), рекуррентные нейронные сети можно научить моделировать язык. И возникает интересный вопрос: возможно ли обучение сети на определенных данных для генерации осмысленного ответа? Например, можем ли мы научить нейронную сеть переводить с английского языка на французский? Оказывается, что можем.

Это руководство покажет вам, как создать и обучить такую систему end-to-end. Скопируйте основной репозиторий Tensor Flow и репозиторий моделей TensorFlow с GitHub. Затем, можно начать с запуска программы перевода:

cd models/tutorials/rnn/translate
python translate.py --data_dir [your_data_directory]

Модели Sequence-to-Sequence Ч.1 - 1Читать полностью »

Data Engineering и не только: видеозаписи и слайды с митапа - 1

15 ноября в офисе Wrike прошел митап «Data Engineering и не только». Поговорили об инженерах данных как об отдельной специальности, наметили отличия процессов в софтверном и дата-инжениринге, посмотрели, как можно писать тесты для Apache Spark, и чуть-чуть коснулись особенностей семантических технологий.

Для тех, кто не смог прийти, мы публикуем видеозаписи докладов.
Читать полностью »


https://ajax.googleapis.com/ajax/libs/jquery/3.4.1/jquery.min.js