Рубрика «СУБД» - 6

Для одних Ким Дотком, основатель скандально известного файлообменника «MegaUpload», преступник и интернет-пират, для других — несгибаемый борец за неприкосновенность персональных данных. 12 марта 2017 года состоялась мировая премьера документальной киноленты, в которой приведены интервью с политиками, журналистами и музыкантами, знающими Кима «со всех сторон». Новозеландский режиссер Энни Голдсон с помощью видео из личных архивов рассказывает о сути судебных баталий Доткома с правительством США и другими государственными структурами, провозгласившими бой мировому интернет-пиратству.
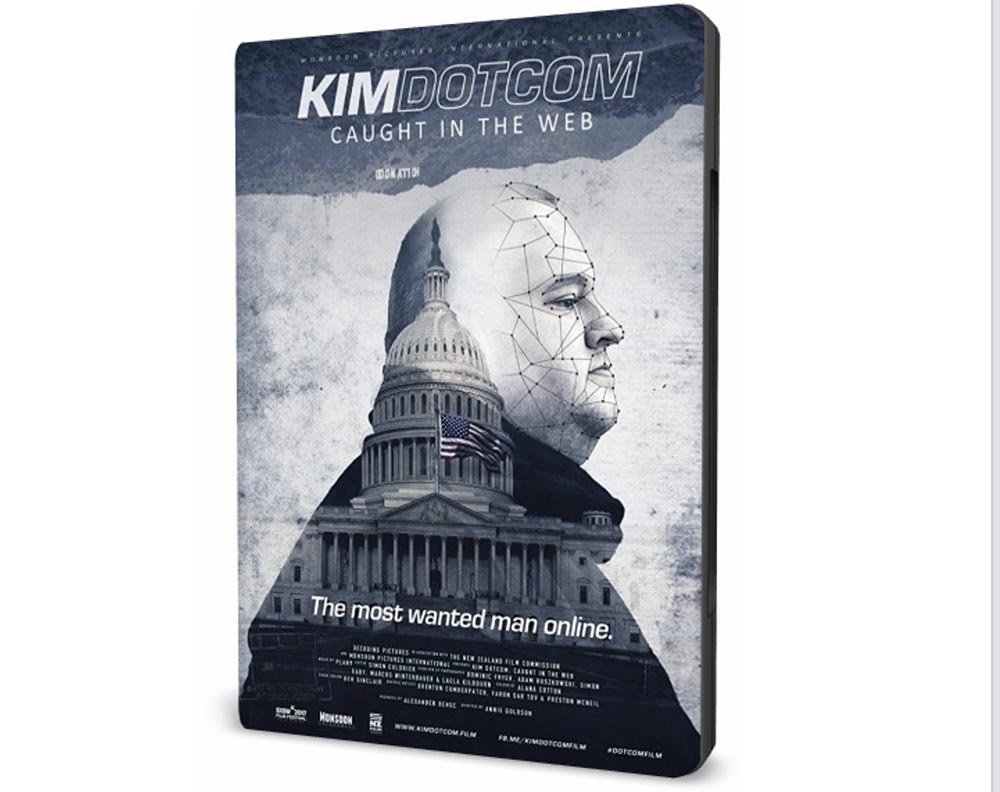
Ким Дотком: пойманный в сеть, самый разыскиваемый человек онлайн. Часть 3 - 1

В юности Ким Дотком считал США оплотом мировой демократии, страной, правительство которой самоотверженно борется за торжество справедливости во всем мире. Побывав в ролях хакера, малолетнего преступника и консультанта по компьютерной безопасности, к 30-ти годам Ким решает заняться бизнесом и создает крупнейший файлообменник «MegaUpload», число пользователей которого достигло 160 млн. человек. Практически до самого закрытия сайта в 2012 году он занимал 13 место в рейтинге самых посещаемых интернет-ресурсов. За 7 лет существования «MegaUpload» Ким заработал более сотни миллионов долларов, но в результате судебных разбирательств превратился в банкрота. Инициатором судебного преследования выступили США, обвинившие Доткома в размещении пиратского контента и нарушении авторских прав, что будто бы принесло правообладателям ущерб в размере 500 млн. долларов.

До сих пор Киму так и не удалось оправиться от удара и поправить финансовые дела, так как все средства он тратит на услуги адвокатов и создание новых инновационных проектов, таких как платформа «K.im» — так называемый «магазин файлов», совершающий платежи на основе криптовалюты.

В статье рассказывается о сюжете фильма «Пойманный в сеть», а также приводятся выдержки из других публицистических материалов, недоступных русскоязычному читателю.Читать полностью »
Через такое прошли многие стартапы: каждый день регистрируются толпы новых пользователей, а команда разработчиков изо всех сил пытается поддержать работу сервиса.

Это приятная проблема, но в Сети мало чёткой информации, как аккуратно масштабировать веб-приложение с нуля до сотен тысяч пользователей. Обычно встречаются или пожарные решения, или устранение узких мест (а часто и то, и другое). Поэтому люди используют довольно шаблонные приёмы по масштабированию своего любительского проекта в нечто действительно серьёзное.

Попытаемся отфильтровать информацию и записать основную формулу. Мы собираемся пошагово масштабировать наш новый сайт для обмена фотографиями Graminsta с 1 до 100 000 пользователей.

Запишем, какие конкретные действия необходимо сделать при увеличении аудитории до 10, 100, 1000, 10 000 и 100 000 человек.
Читать полностью »

В любой крупной компании, и X5 Retail Group не исключение, по мере развития возрастает количество проектов, где требуется авторизация пользователей. С течением времени требуется бесшовный переход пользователей из одного приложения в другой и тогда возникает необходимость использования единого сервера Single-Sing-On (SSO). Но как быть, когда такие идентификационные провайдеры как AD или иные, не обладающие дополнительными атрибутами, уже используются в различных проектах. На помощь придет класс систем под названием «идентификационные брокеры». Наиболее функциональными являются его представители, такие как Keycloak, Gravitee Access management и пр. Чаще всего сценарии использования могут быть различны: машинное взаимодействие, участие пользователей и пр. Решение должно поддерживать гибкий и масштабируемый функционал, способный объединить все требования в одном, и такие решением в нашей компании сейчас является индикационный брокер – Keycloak.

SSO на микросервисной архитектуре. Используем Keycloak. Часть №1 - 1
Читать полностью »

Массивно-параллельная база данных Greenplum — короткий ликбез - 1

Для Hadoop и Greenplum есть возможность получить готовый SaaS. И если Хадуп — известная штука, то Greenplum (он лежит в основе продукта АrenadataDB, про который далее пойдёт речь) — интересная, но уже менее «на слуху».

Arenadata DB — это распределённая СУБД на базе опенсорсного Greenplum. Как и у других решений MPP (параллельной обработки данных), для массивно-параллельных систем архитектура облака далека от оптимальной. Это может снижать производительность аж до 30 % (обычно меньше). Но, тем не менее, эту проблему можно нивелировать (о чём речь пойдёт ниже). Кроме того, стоит покупать такую услугу из облака, часто это удобно и выгодно в сравнении с развёртыванием собственного кластера.

В гайдах явно указывается on-premise, но сейчас многие осознают масштаб удобства облака. Все понимают, что некая деградация производительности будет, но это настолько всё равно супер по удобству и скорости, что уже есть проекты, где этим жертвуют на каких-то этапах вроде проверки гипотез.

Если у вас есть хранилище данных больше 1 ТБ и транзакционные системы — не ваш профиль по нагрузке, то ниже — рассказ, что можно сделать как вариант. Почему 1 ТБ? Начиная с этого объёма использование MPP эффективнее по соотношению производительность/стоимость, если сравнивать с классическими СУБД. Читать полностью »

Postgres-вторник №5: «PostgreSQL и Kubernetes. CI-CD. Автоматизация тестирования» - 1

В конце минувшего года состоялся очередной прямой эфир российского PostgreSQL-сообщества #RuPostgres, в рамках которого его сооснователь Николай Самохвалов поговорил с техническим директором «Фланта» Дмитрием Столяровым про эту СУБД в контексте Kubernetes.

Мы публикуем стенограмму основной части этой дискуссии, а на YouTube-канале сообщества опубликована полная видеозапись:Читать полностью »

HighLoad++ Moscow 2018, зал «Конгресс-холл». 9 ноября, 15:00

Тезисы и презентация: http://www.highload.ru/moscow/2018/abstracts/4066

Юрий Насретдинов (ВКонтакте): в докладе будет рассказано об опыте внедрения ClickHouse в нашей компании – для чего он нам нужен, сколько мы храним данных, как их пишем и так далее.

HighLoad++, Юрий Насретдинов (ВКонтакте): как VK вставляет данные в ClickHouse с десятков тысяч серверов - 1

Дополнительные материалы: использование Clickhouse в качестве замены ELK, Big Query и TimescaleDBЧитать полностью »

Логические поля в базах данных, есть ли противоядие - 1

Часто в таблицах содержится большое количество логических полей, проиндексировать все из них нет возможности, да и эффективность такой индексации низка. Тем не менее, для работы с произвольными логическими выражениями в SQL пригоден механизм многомерной индексации о чем и пойдёт речь под катом.
Читать полностью »

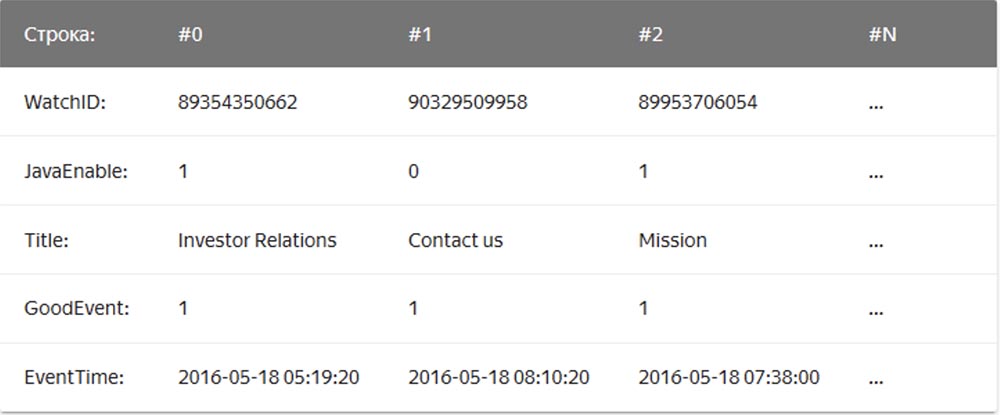
Clickhouse — это столбцовая система управления базами данных для онлайн обработки аналитических запросов (OLAP) с открытым исходным кодом, созданная Яндексом. Ее используют Яндекс, CloudFlare, VK.com, Badoo и другие сервисы по всему миру для хранения действительно больших объемов данных (вставка тысяч строк в секунду или петабайты данных, хранящихся на диске).

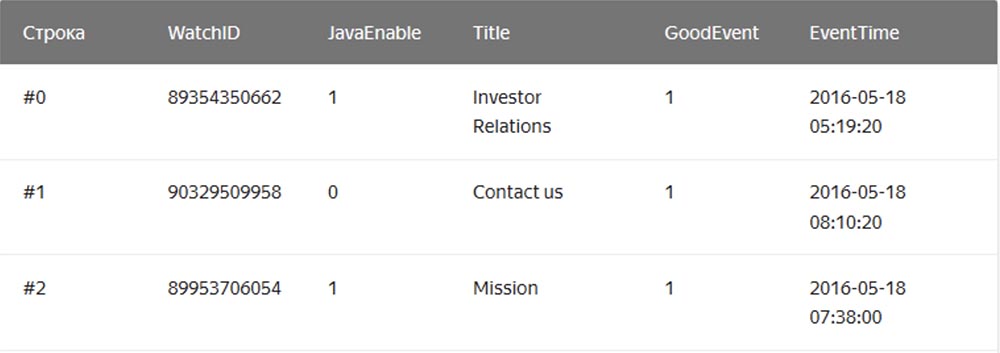
В обычной, «строковой» СУБД, примерами которых служат MySQL, Postgres, MS SQL Server, данные хранятся в таком порядке:

Использование Clickhouse в качестве замены ELK, Big Query и TimescaleDB - 1

При этом значения, относящиеся к одной строке, физически хранятся рядом. В столбцовых СУБД значения из разных столбцов хранятся отдельно, а данные одного столбца – вместе:

Использование Clickhouse в качестве замены ELK, Big Query и TimescaleDB - 2Читать полностью »

СУБД Postgres Pro Standard придумана для того, чтобы доставлять наши разработки пользователям быстрее, чем мы можем это сделать через PostgreSQL. Те фичи, которые еще не вошли в PostgreSQL, но находятся на твердом пути туда, мы включаем в Postgres Pro Standard. Также в Postgres Pro Standard входят некоторые расширения, которые востребованы нашими клиентами, но отсутствуют в обычной поставке PostgreSQL.

Иногда бывают исключения, когда в Postgres Pro Standard по просьбам юзеров и для их удовлетворения включаются и менее тривиальные фичи, которым по-хорошему место только в Postgres Pro Enterprise. В частности, это PTRACK, о нём ниже.

Не все, но изрядная доля дополнительных расширений и утилит, входящих в Standard, разработана в Postgres Professional. Все патчи Postgres Pro придуманы и реализованы нашими силами. Начнем с улучшений, потребовавших вмешательства в ядро СУБД.
Читать полностью »

«Покрывающий индекс» не просто еще одна фича, которая может пригодиться. Это вещь сугубо практичная. Без них Index Only Scan может не дать выигрыша. Хотя и покрывающий индекс в разных ситуациях эффективен по-разному.

Речь здесь будет не совсем о покрывающих индексах: строго говоря, в Postgres появились так называемые инклюзивные индексы. Но, по-порядку: покрывающий индекс — это индекс, который содержит все значения столбцов, необходимые запросу; при этом обращение к самой таблице уже не требуется. Почти. О «почти» и других нюансах можно прочитать в статье Егора Рогова, входящей в его индексный сериал из 10 (!) частей. А инклюзивный индекс создается специально для поиска по типичным запросам: к поисковому индексу добавляются значения полей, по которым искать нельзя, они нужны только для того, чтобы не обращаться лишний раз к таблице. Такие индексы формируются с ключевым словом INCLUDE.

Анастасия Лубенникова (Postgres Professional) доработала метод btree так, чтобы в индекс можно было включать дополнительные столбцы. Этот патч вошел в версию PostgreSQL 11. Но патчи для методов доступа GiST/SP-GiST не успели созреть до выхода этой версии. К 12-й GiST дозрел.
Читать полностью »


https://ajax.googleapis.com/ajax/libs/jquery/3.4.1/jquery.min.js