Рубрика «cnn» - 3

7 лет хайпа нейросетей в графиках и вдохновляющие перспективы Deep Learning 2020-х - 1

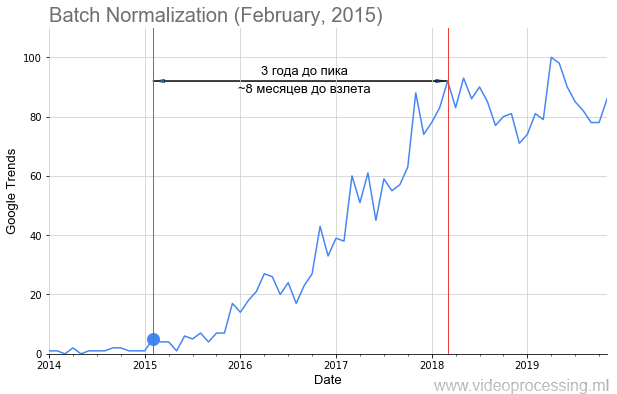
Новый год все ближе, скоро закончатся 2010-е годы, подарившие миру нашумевший ренессанс нейросетей. Мне не давала покоя и лишала сна простая мысль: «Как можно ретроспективно прикинуть скорость развития нейросетей?» Ибо «Тот, кто знает прошлое — тот знает и будущее». Как быстро «взлетали» разные алгоритмы? Как вообще можно оценить скорость прогресса в этой области и прикинуть скорость прогресса в следующем десятилетии? 
7 лет хайпа нейросетей в графиках и вдохновляющие перспективы Deep Learning 2020-х - 2

Понятно, что можно примерно посчитать количество статей по разным областям. Метод не идеальный, нужно учитывать подобласти, но в целом можно пробовать. Дарю идею, по Google Scholar (BatchNorm) это вполне реально! Можно считать новые датасеты, можно новые курсы. Ваш же покорный слуга, перебрав несколько вариантов, остановился на Google Trends (BatchNorm). 

Мы с коллегами взяли запросы основных технологий ML/DL, например, Batch Normalization, как на картинке выше, точкой добавили дату публикации статьи и получили вполне себе график взлета популярности темы. Но не у всех тем путь усыпан розами взлет такой явный и красивый, как у батчнорма. Некоторые термины, например регуляризацию или skip connections, вообще не получилось построить из-за зашумленности данных. Но в целом тренды собрать удалось.

Кому интересно, что получилось — добро пожаловать под кат!
Читать полностью »
Наткнулся на статью в блоге компании Школа Данных и решил проверить, на что способна библиотека Fast.ai на том же датасете, который упоминается в статье. Здесь вы не найдете рассуждений о том, своевременно и правильно диагностировать пневмонию, будут ли нужны врачи-рентгенологи, можно ли считать предсказание нейронной сети медицинским диагнозом и т.д. Основная цель — показать, что машинное обучение в современных библиотеках может быть довольно простым (буквально требует немного строчек кода) и дает отличные результаты. Запомним пока результат из статьи (precision = 0.84, recall = 0.96) и посмотрим, что получится у нас.Читать полностью »

После экспериментов с многим известной базой из 60000 рукописных цифр MNIST возник логичный вопрос, есть ли что-то похожее, но с поддержкой не только цифр, но и букв. Как оказалось, есть, и называется такая база, как можно догадаться, Extended MNIST (EMNIST).

Если кому интересно, как с помощью этой базы можно сделать несложную распознавалку текста, добро пожаловать под кат.

Python + OpenCV + Keras: делаем распознавалку текста за полчаса - 1
Читать полностью »

Полный курс на русском языке можно найти по этой ссылке.
Оригинальный курс на английском доступен по этой ссылке.

Погружение в свёрточные нейронные сети. Часть 5 - 1 — 9 - 1
Выход новых лекций запланирован каждые 2-3 дня.

Читать полностью »

Полный курс на русском языке можно найти по этой ссылке.
Оригинальный курс на английском доступен по этой ссылке.
Введение в свёрточные нейронные сети (Convolutional Neural Networks) - 1
Выход новых лекций запланирован каждые 2-3 дня.
Читать полностью »

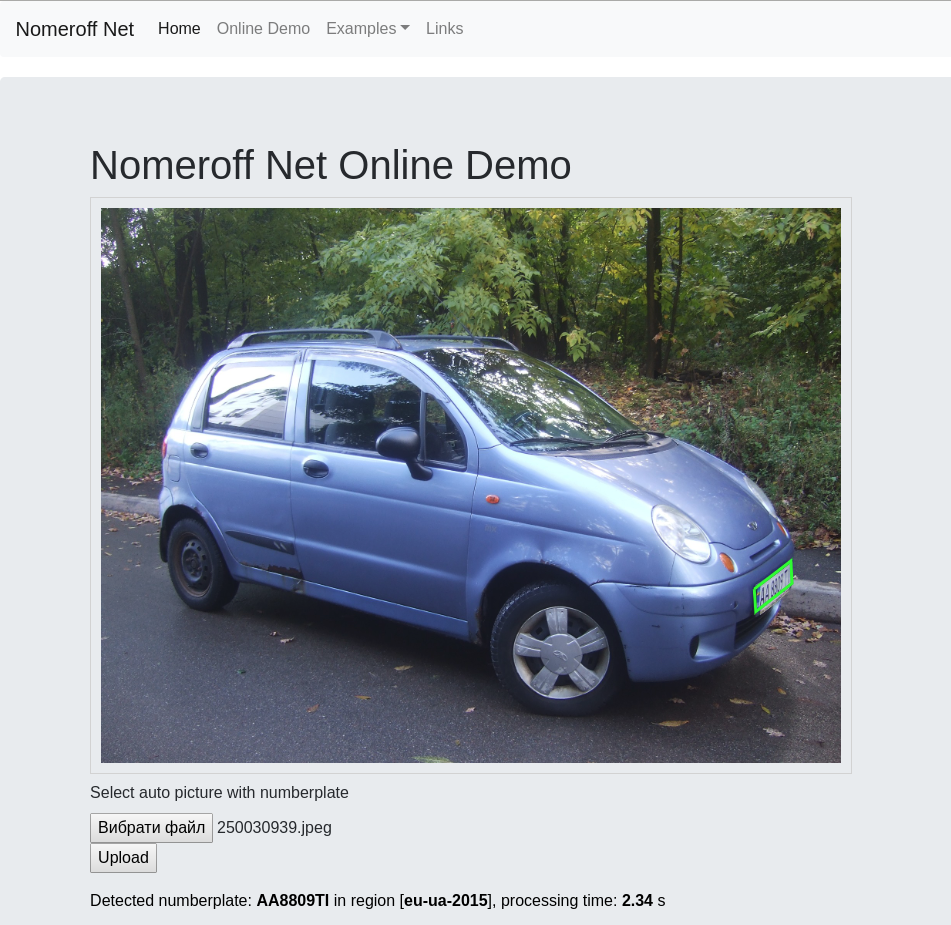
Nomeroff Net numberplate detection OCR example

Продолжаем рассказ о том как распознавать номерные знаки для тех кто умеет писать приложение «hello world» на python-е! В этой части научимся тренировать модели, которые ищут регион заданного объекта, а также узнаем как написать простенькую RNN-сеть, которая будет справляться с чтением номера лучше чем некоторые коммерческие аналоги.
В этой части я расскажу как тренировать Nomeroff Net под Ваши данные, как получить высокое качество распознавания, как настроить поддержку GPU и ускорить все на порядок…
Читать полностью »

Насколько сложна тема машинного обучения? Если Вы неплохо математически подкованы, но объем знаний о машинном обучении стремится к нулю, как далеко Вы сможете зайти в серьезном конкурсе на платформе Kaggle?

Kaggle: не можем ходить — будем бегать - 1
Читать полностью »

Взлом музыки для демократизации производного контента

Отказ от ответственности: вся интеллектуальная собственность, проекты и методы, описанные в этой статье, раскрыты в патентах US10014002B2 и US9842609B2.

Вот бы вернуться в 1965 год, постучать в парадную дверь студии «Эбби-Роуд» с пропуском, зайти внутрь — и услышать настоящие голоса Леннона и Маккартни… Что ж, давайте попробуем. Входные данные: MP3 среднего качества песни «Битлз» We Can Work it Out. Верхняя дорожка — входной микс, нижняя дорожка — изолированный вокал, который выделила наша нейросеть.

Читать полностью »

Пример распознавания номерных знаков
Все начиналось банально — моя компания уже год платила ежемесячно плату за сервис, который умел находить регион с номерными знаками на фото. Эта функция применяется для автоматической зарисовки номера у некоторых клиентов.

И в один прекрасный день МВД Украины открыло доступ к реестру транспортных средств. Теперь по номерному знаку стало возможным проверять некоторую информацию про автомобиль (марку, модель, год выпуска, цвет и т.д. )! Скучная рутина линейного программирования померкла перед новой свехзадачей — считывать номера по всей базе фото и валидировать эти данные с теми, что указывал пользователь. Сами знаете как это бывает «глаза загорелись» — вызов принят, все остальные задачи на время стали скучны и монотонны… Мы принялись за работу и получили неплохие результаты, чем, собственно и решили поделиться с сообществом.

Для справки: на сайт AUTO.RIA.com, в день добавляется около 100 000 фото.

Датасаентисты давно уже знают и умеют решать подобные задачи, поэтому мы с dimabendera написали эту статью именно для программистов. Если вы не боитесь словосочетания «сверточные сети» и умеете писать «Hello World» на питоне — милости просим под кат…
Читать полностью »

Здравствуйте, коллеги!

Из последних известий по нашим планируемым новинкам из области ML/DL:

Нишант Шакла, "Машинное обучение с Tensorflow" — книга в верстке, ожидается в магазинах в январе

Делип Рао, Брайан Макмахан, "Обработка естественного языка на PyTorch" — контракт подписан, планируем приступать к переводу в январе.

В данном контексте мы хотели в очередной раз вернуться к болезненной теме — слабой проработке темы ML/DL в языке Java. Из-за явной незрелости этих решений и алгоритмов на языке Java мы когда-то приняли решение отказаться от книги Гибсона и Паттерсона по DL4J, и публикуемая сегодня статья Хамфри Шейла (Humphrey Sheil) подсказывает, что мы, вероятно, были правы. Предлагаем познакомиться с мыслями автора о том, каким образом язык Java мог бы наконец составить конкуренцию Python в машинном обучении
Читать полностью »


https://ajax.googleapis.com/ajax/libs/jquery/3.4.1/jquery.min.js