Рубрика «big data» - 77

О том, что за BigData помноженной на искусственный интеллект стоит невероятное будущее написано уже чуть ли не больше, чем собрание сочинений братьев Стругацких и Жуля Верна вместе взятых. Все они, и не совсем без основательно, утверждают, что собранные огромные массивы данных, обработанные с помощью, например, Deep Learning смогут уже сегодня выявить всех мошенников, предотвратить сомнительные сделки и предсказать самые высокодоходные рынки. Сама же по себе финансовая отрасль станет полностью автоматизированной под управлением мудрого искусственного интеллекта.

Наверное, так и будет до некоторой степени. Уже сегодня степень автоматизации достигла такого уровня, который еще 10 лет назад казался фантастикой. Все так… Но, как известно, «мелочи» могут привнести множество сюрпризов. Одной из таких мелочей является тот факт, что львиная доля всех данных, которые можно и нужно было бы использовать в задачах борьбы с мошенничеством, прогнозированием рынков представляют собой текстовые данные. Количество ежедневно порождаемых письменных, видео и других данных составляет миллиарды строк, анализ которых с помощью операторов практически бесполезен. Кто-то может, поспорить, что все не так и большинство данных представляют собой обычные таблицы, которые хорошо обрабатываются статистическими методами. И, казалось бы, он будет прав. Банки из TOP-30 рапортуют о широком использовании BigData. Читать полностью »
Термином «визуализация данных» сейчас никого не удивишь. Классных примеров визуализации в сети становится всё больше, и я уверена, что многиее с удовольствием исследуют их и делятся интересными находками с друзьями в соцсетях. А кто из вас задумывался, какую пользу визуализация данных может принести в вашей повседневной работе или для вашего бизнеса?

5 причин посетить курс по визуализации данных - 1
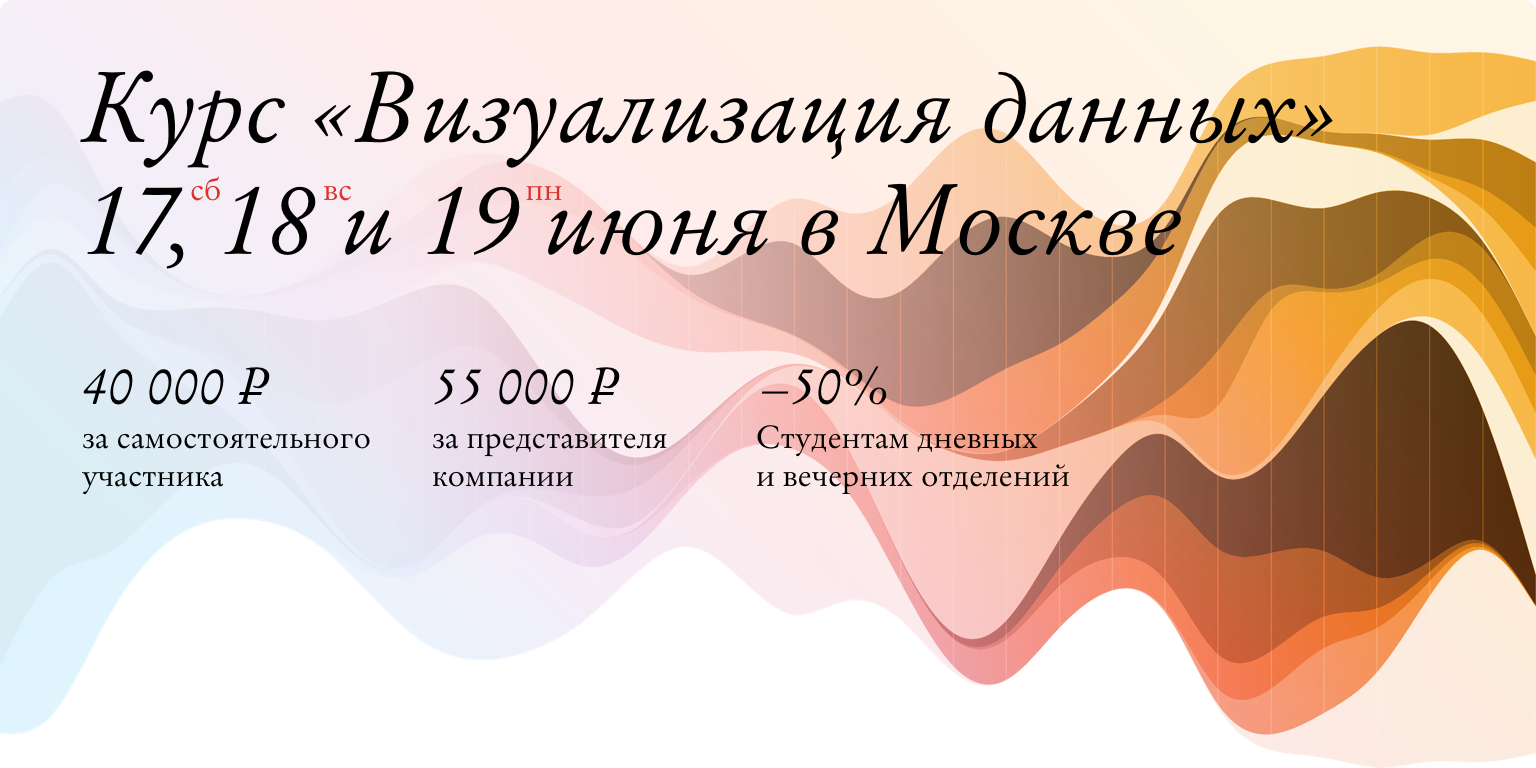
17, 18 и 19 июня в Москве пройдёт учебный курс по визуализации данных. Этот курс не для всех, мы адресуем его аналитикам, дизайнерам интерфейсов, разработчикам и руководителям проектов, которые имеют дело со сложными данными. Но мне кажется, что далеко не все, кому курс будет полезен, задумываются о таком обучении.

Я расскажу, зачем специалисту или менеджеру идти на наш курс, какие знания и навыки он получит. Буду рада, если эти причины зацепят кого-то из читателей, подтолкнут к самостоятельным исследованиям или приведут в нашу уютную учебную группу.

Читать полностью »

Приглашаем на Moscow Data Science 31 мая - 1

31 мая в офисе Mail.Ru Group состоится традиционная встреча сообщества Moscow Data Science. Вы сможете обменяться профессиональным опытом решения практических задач анализа данных и пообщаться в неформальной обстановке. В программе встречи три доклада, подробности читайте под катом.
Читать полностью »

Культ карго искусственного интеллекта - 1

Говорят, что в будущем ИИ станут настолько умнее, что лишат нас работы, потом ресурсов, и люди вымрут. Так ли это? Под катом интересное мнение Кевина Келли. Если у вас все хорошо с английским, то оригинал публикации вы сможете найти тут. Читать полностью »

В апреле 2017 года во Франции запущена национальная система данных о здоровье, объединяющая данные о здоровье пациентов из различных источников (« Système national des données de santé » — SNDS).

Система является уникальной в Европе. Она объединяет в себе уже существующие базы данных страховых компаний, больниц, информацию о смертельных случаях и информацию об инвалидности. Эти объединенные данные предполагается использовать для проведения медицинских исследований на основе больших данных и в отношении длящихся заболеваний.

Содержание системы. В систему включены данные о Читать полностью »

В последнее время имена GridGain и Apache Ignite нередко мелькают в интернетах. Однако, судя по комментариям (например, здесь), мало кто понимает, что же это за продукт и с чем его едят.

В этой статье я попытаюсь доступным языком объяснить, и на примерах кода показать, что умеет Apache Ignite.

Apache Ignite Logo

Читать полностью »

Введение

В этой статье я продолжу рассказ о своем опыте работы с Microsoft Analysis Services. В дополнение к предыдущей статье, я хочу написать про нестандартные решения, которые были сделаны в последнем проекте. Эти решения более тесно сблизили меня с Microsoft Analysis Services, я стал больше его уважать и делать с его помощью то, что ранее мне казалось невероятным.
Читать полностью »

Deep Learning против рака. Конкурс Intel - 1

Рак шейки матки — страшное заболевание, ежегодно уносящее сотни тысяч жизней. Но еще страшнее то, что большинство этих жизней можно было спасти. Рак шейки матки развивается очень медленно, и в случае обнаружения опухоли в первые 5 лет после ее появления шанс выживания практически 100%. Таким образом, регулярные обследования могут извести это заболевание на корню. К сожалению, 85% женщин Земли регулярная медицинская помощь недоступна. Их могут спасти технологии машинного распознавания фотоснимков, снижающие требования к квалификации врачебного персонала и увеличивающие процент правильных диагнозов. Именно такие алгоритмы распознавания и создаются в рамках конкурса программистов Intel & MobileODT Cervical Cancer Screening, в котором мы приглашаем вас поучаствовать.
Читать полностью »

image

Привет!

В последнее время все чаще приходится наблюдать, что ожидания работодателей и потенциальных ученых по данными сильно отличаются. Компания, инвестируя в новые разработки в первую очередь ждет возврат на инвестиции, а не очередную модель. Специалист же, окончивший всевозможные курсы ждет на вход чистые и понятные данные, а на выходе хотел бы отдать модель прикрепив к ней метрики качества. А дальше «пусть менеджеры разбираются», как это все будет встроено в процесс и как именно полученная модель будет использоваться. В результате возникает пропасть и непонимание между бизнесом и учеными.

По факту оказывается, что модели сами по себе никому не нужны, а на деле приходится заниматься очень большим количеством рутинных задач.

Хотелось бы на обобщенных примерах (все совпадения с реальной жизнью случайны) показать, какие же на самом деле трудности приходится преодолевать, чтобы принести работодателю деньги. Наверное, после этого в аналитику данных люди будут идти более осознанно, попутно получая нужные для работы навыки, а не изучая очередную статью про алгоритм.
Читать полностью »

Рост автономных платформ обработки данных или еще раз про Big Data - 1

Большие данные сегодня, ну, БОЛЬШИЕ. В исследовании IDC за 2016 год под названием «Полугодовое руководство по расходам на большие данные и аналитику» прогнозируется, что общемировой оборот на больших данных вырастет со $130 млрд в 2016-м до более чем $203 млрд в 2020-м, то есть совокупный годовой рост будет на уровне 11,7%. По мнению IDC, росту способствуют три фактора: увеличение доступности гигантских объёмов данных, богатый ассортимент развивающихся open source-технологий для работы с большими данными, культурный сдвиг в бизнес-среде в направлении принятия решений на основе анализа массива данных. Звучит правильно, да? А если допустить, что это не совсем так. Повсюду публикуется множество отчётов о неудачах, постигающих инициативы, связанные с большими данными. В этой статье мы обсудим причины этих неудач, почему решения, принимаемые для исправления ситуации, являются лишь временными мерами, и почему автономные платформы обработки данных являются жизнеспособным долгосрочным решением.Читать полностью »


https://ajax.googleapis.com/ajax/libs/jquery/3.4.1/jquery.min.js