
Несколько человек, близких к «Ростелекому» и знакомые сотрудников оператора рассказали «Ведомостям», что до 1 июня президент оператора Михаил Осеевский примет решение о будущем проекта «Спутник». Закрытие маловероятно, — утверждает человек, представленный как знакомый менеджеров «Ростелекома» — возможноЧитать полностью »
Рубрика «big data» - 78
Новый глава «Ростелекома» подхватил традицию Калугина раз в год переосмысливать «Спутник»
2017-05-12 в 3:59, admin, рубрики: B2B, big data, Госвеб, инвестиции, кейсы, Михаил Осеевский, поиск, Ростелеком, спутник, Стратегия, Текучка, телеком, эффективность бизнеса, метки: b2b, big data, Госвеб, инвестиции, кейсы, Михаил Осеевский, поиск, Ростелеком, спутник, Стратегия, Текучка, телеком, эффективность бизнесаВведение в OpenCV применительно к распознаванию линий дорожной разметки
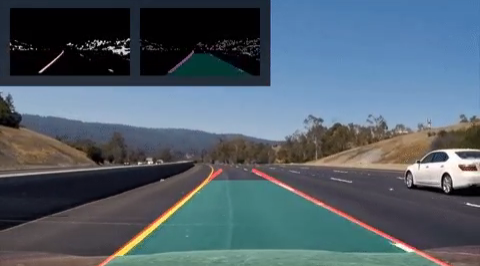
2017-05-11 в 11:20, admin, рубрики: artificial intelligence, big data, computer vision, data mining, opencv, self driving cars, автопилот, Блог компании New Professions Lab, машинное обучениеПривет! Публикуем материал выпускника нашей программы Deep Learning и координатора программы по большим данным, Кирилла Данилюка о его опыте использования фреймворка компьютерного зрения OpenCV для определения линий дорожной разметки.
Часть 3. Где хранить данные децентрализованным приложениям на блокчейне?
2017-05-04 в 10:51, admin, рубрики: big data, blockchain, byzantine fault tolerance, cassandra, elassandra, elasticsearch, Ethereum, nosql, open source, Анализ и проектирование систем, базы данных, блокчейн, децентрализация, децентрализованные сети, концепт, криптография, мотивация, хранение данных, хранилище данныхВ первой части статьи мы обнаружили проблемы с хранением данных приложений в блокчейне. Во второй части мы описали требования к хранилищу данных и рассмотрели, насколько существующие реализации отвечают этим требованиям. Результаты были неутешительные — удовлетворительной реализации не нашлось. В данной части мы предложим концепцию децентрализованного хранилища данных, которое удовлетворяет поставленным требованиям. Разумеется, для более глубокого понимания сути происходящего рекомендуется просмотреть две предыдущие части.
Читать полностью »
Часть 1. Где хранить данные децентрализованным приложениям на блокчейне?
2017-05-02 в 19:46, admin, рубрики: big data, bitcoin, blockchain, cryptocurrency, data storage, decentralization, decentralized systems, Ethereum, nosql, open source, smart contracts, Анализ и проектирование систем, базы данных, криптографияСейчас наблюдается бум блокчейн проектов. Некоторые блокчейны насколько мощные, что являются платформой для написания приложений. Приложения автоматически получаются децентрализованными, устойчивыми к цензуре и блокировке. Но действительно ли всё так хорошо и просто? В данной статье мы постараемся посмотреть на блокчейн как платформу для приложений, сняв розовые очки.
Читать полностью »
Отчет с Data Fest⁴ 11-12 февраля
2017-05-02 в 15:09, admin, рубрики: big data, data fest, data mining, mail.ru, Блог компании Mail.Ru Group, конференция, машинное обучение
11-12 февраля в нашем московском офисе состоялась четвертая конференция Data Fest⁴, объединившая исследователей, инженеров и разработчиков, связанных с Data Science во всех его проявлениях. Под катом мы подготовили для вас видеоматериалы с конференции.
Читать полностью »
Видеозапись вебинара «Julia — A fresh approach to numerical computing and data science»
2017-04-29 в 8:38, admin, рубрики: big data, BigData, data mining, data science, deep learning, FlyElephant, gpu, HPC, Julia, machine learning, mpi, xeon phi, Блог компании FlyElephant, вебинар, машинное обучение
Команда FlyElephant в марте проводила вебинар с со-основателем и CEO в Julia Computing, а также со-автором языка Julia — Viral B. Shah, на тему "Julia — A fresh approach to numerical computing and data science".
Конфигурирование Spark на YARN
2017-04-28 в 9:40, admin, рубрики: Apache Spark, big data, data mining, spark, YARN, Блог компании New Professions Lab, машинное обучение Вчера на митапе, посвященном Apache Spark, от ребят из Rambler&Co, было довольно много вопросов от участников, связанных с конфигурированием этого инструмента. Решили по его следам поделиться своим опытом. Тема непростая — поэтому предлагаем делиться опытом тоже в комментариях, может быть, мы тоже что-то не так понимаем и используем.
Читать полностью »
Спортивный анализ данных, или как стать специалистом по data science
2017-04-26 в 14:05, admin, рубрики: adam, big data, black box, data mining, data science, ImageNet, inceptionV3, kaggle, mxnet, Q-learning, resnet, xgboost, аугментация данных, блендинг, Блог компании Яндекс, валидация, классификация, конкурсы разработчиков, контест, машинное обучение, нейронные сети, распознавание изображений, Спортивное программирование, стекинг, тренировки, черный ящикМеня зовут Пётр Ромов, я — data scientist в Yandex Data Factory. В этом посте я предложу сравнительно простой и надежный способ начать карьеру аналитика данных.
Многие из вас наверняка знают или хотя бы слышали про Kaggle. Для тех, кто не слышал: Kaggle — это площадка, на которой компании проводят конкурсы по созданию прогнозирующих моделей. Её популярность столь велика, что часто под «кэглами» специалисты понимают сами конкурсы. Победитель каждого соревнования определяется автоматически — по метрике, которую назначил организатор. Среди прочих, Kaggle в разное время опробовали Facebook, Microsoft и нынешний владелец — Google. Яндекс тоже несколько раз отметился. Как правило, Kaggle-сообществу дают решать задачи, довольно близкие к реальным: это, с одной стороны, делает конкурс интересным, а с другой — продвигает компанию как работодателя с солидными задачами. Впрочем, если вам скажут, что компания-организатор конкурса задействовала в своём сервисе алгоритм одного из победителей, — не верьте. Обычно решения из топа слишком сложны и недостаточно производительны, а погони за тысячными долями значения метрики не настолько и нужны на практике. Поэтому организаторов больше интересуют подходы и идейная часть алгоритмов.
Kaggle — не единственная площадка с соревнованиями по анализу данных. Существуют и другие: DrivenData, DataScience.net, CodaLab. Кроме того, конкурсы проводятся в рамках научных конференций, связанных с машинным обучением: SIGKDD, RecSys, CIKM.
Для успешного решения нужно, с одной стороны, изучить теорию, а с другой — начать практиковать использование различных подходов и моделей. Другими словами, участие в «кэглах» вполне способно сделать из вас аналитика данных. Вопрос — как научиться в них участвовать?
Видеозаписи докладов конференции AI&BigDataLab за последние три года
2017-04-26 в 7:25, admin, рубрики: AI&BigDataLab, artificial intelligence, big data, data mining, Data Science Lab, FlyElephant, R, Блог компании FlyElephant, Большие данные, видеозаписи докладов, искусственный интеллект, конференция, машинное обучение
Через 2 недели, 13 мая в Одессе, команда FlyElephant будет проводить конференцию Data Science Lab. Это будет наша 4-я конференция, которая посвящена искусственному интеллекту, большим данным и науке о данных.
Сегодня я хочу поделиться видеозаписями всех докладов с прошлых конференций. Смотрите, изучайте и делитесь:
Как мы построили облачную инфраструктуру обработки данных для кросс-продуктовой аналитики
2017-04-26 в 3:59, admin, рубрики: Amazon Web Services, big data, bigquery, data warehouse, mode, plotly, product analytics, redash, redshift, segment, stitch, Блог компании Skyeng, визуализация данных
Мы в Skyeng очень много внимания уделяем анализу данных. Он позволяет нам правильно планировать работу и распределять ресурсы между различными задачами. Сегодня разработчик аналитики Глеб Сологуб расскажет, как он собрал для нас инфраструктуру сбора и анализа данных по всему нашему зоопарку сервисов и приложений, уложившись в годовой бюджет 12 тыс долларов.