Налоговая отдаёт данные ЕГРЮЛ по организации в виде PDF. Посредники за автоматический доступ по API хотят денег. На многих сайтах часть данных закрыто, часть функций недоступны бесплатно, и полно рекламы.
Налоговая отдаёт данные ЕГРЮЛ по организации в виде PDF. Посредники за автоматический доступ по API хотят денег. На многих сайтах часть данных закрыто, часть функций недоступны бесплатно, и полно рекламы.
Всем привет! Эта статья - обобщение моего опыта 30+ проектов, связанных с обработкой данных и машинным обучением. Здесь не будет теории про управление рисками и общего перечня проектных рисков. Я перечислил только наиболее частые “грабли” именно из data-специфики, с которыми приходилось сталкиваться за последние 7 лет. Надеюсь, что эта статья поможет менеджеру проекта или менеджеру продукта сохранить свой цвет волос, ценное время команды и удовлетворенность заказчиков. Риски я разделил на три группы:
риски моделей машинного обучения,
риски источников данных,
риски пользовательских данных.
Поймал себя на ощущении, что очень хочется поделиться своим опытом работы с интеловской энергонезависимой памятью (Intel Optane memory или Intel PMem = persistent memory). Я буду для краткости называть ее ПМем. Думаю, что несмотря на объем продаж в сотни миллионов долларов, пока мало кто с ней сталкивался и знает ее специфику. Я же по долгу службы занимаюсь ей уже довольно продолжительное время и гонял на ней различные приложения и микро-бенчмарки. А также добивался ее эффективного использования модифицируя под нее клиентские коды.
Привет, чемпион! Возможно, ты сейчас участвуешь в соревновании по анализу данных или просто решил погрузиться в мира Data Science. Тогда эта статья будет тебе очень полезна!
Сражу скажу, что трюки, о которых мы сегодня поговорим, я не просто так назвал "грязными". Речь пойдет о вещах, которые в каком-то смысле нечестные или просто вводят в заблуждение других участников соревнований. Долго думал, стоит ли про эти техники вообще рассказывать, ведь в борьбе за призовые всегда велик соблазн начать хитрить. Решил, что все-таки расскажу про некоторые приемы, дабы вооружить честных людей, которые играют по правилам.

После релиза нашей первой модели, расставляющей знаки препинания и большие буквы, было много пожеланий доработать её, чтобы она могла обрабатывать тексты целиком, а не отдельные предложения. Это коллективное пожелание и было осуществлено в нашей новой версии модели.
В целом, архитектура и датасеты остались прежними. Что изменилось:
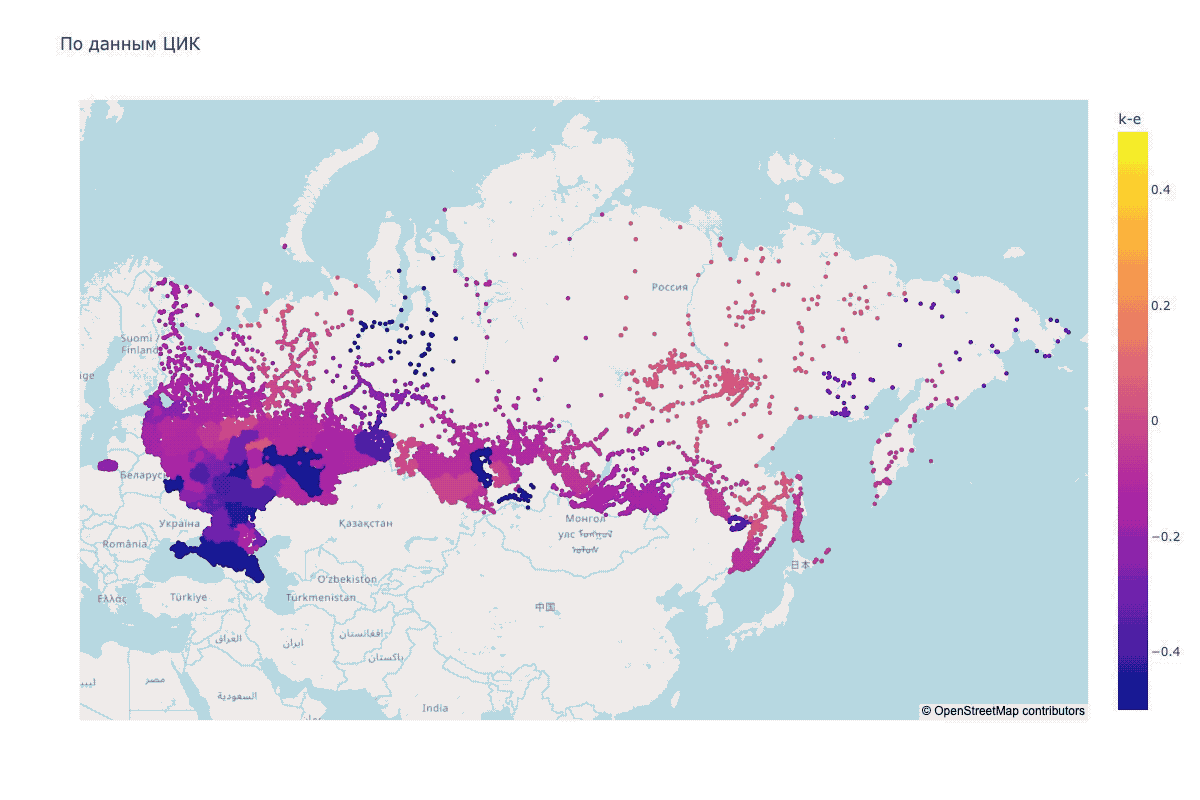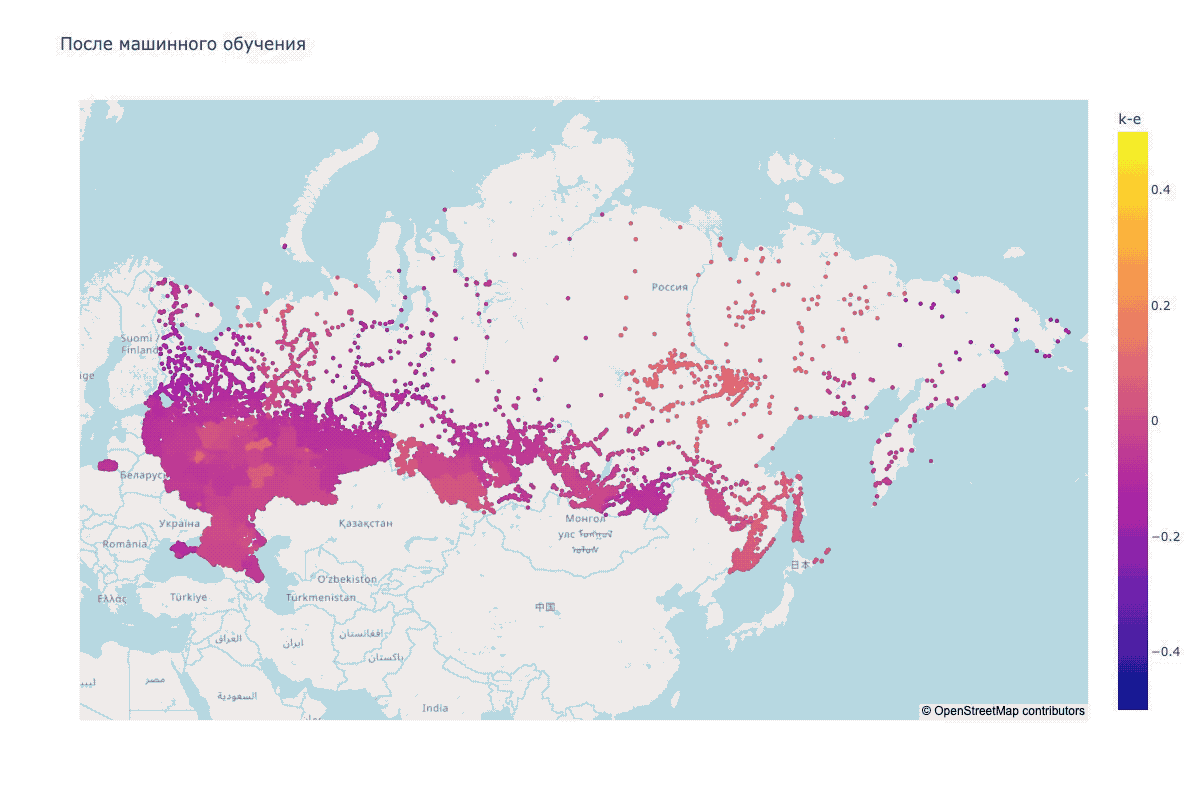
Результаты выборов в государственную думу, которые проходили 17-19 сентября 2021 вызывают сомнения у многих экспертов. Независимый электоральный аналитик Читать полностью »
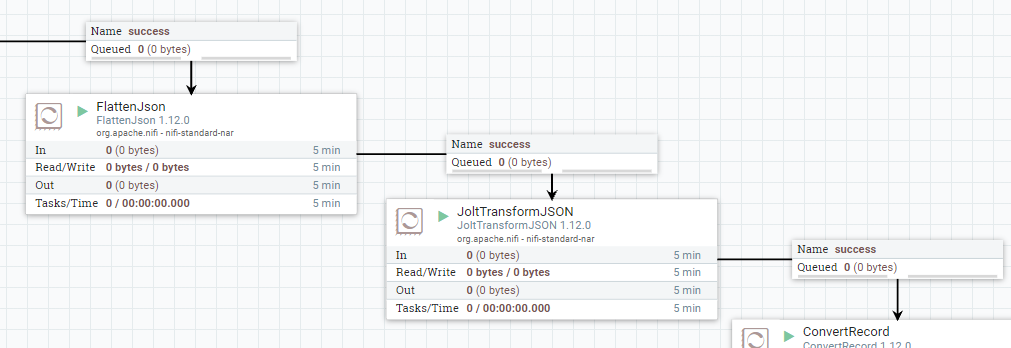
На текущем проекте у нас начинает активно использоваться Apache NiFi в качестве основного ETL/ELT-инструмента. NiFi используется для получения данных из различных источников (Kafka, REST, HDFS) и подготовки данных для их последующей загрузки в основное хранилище на базе GreenplumЧитать полностью »
Меня зовут Даниил Охлопков, и я расскажу про свой подход к написанию скриптов, извлекающих данные из интернета: с чего начать, куда смотреть и что использовать.
Написав тонну парсеров, я придумал алгоритм действий, который не только минимизирует затраченное время на разработку, но и увеличивает их живучесть, робастность, масштабируемость.