Рубрика «machine learning» - 21

Применение зашифрованных данных для машинного обучения без их расшифровки - 1

Применение зашифрованных данных для машинного обучения без их расшифровки
В этой статье обсуждаются передовые криптографические методики. Это лишь обзор исследований, проводимых в Julia Computing. Не используйте приведённые здесь примеры в коммерческих приложениях. Всегда консультируйтесь с криптографами, прежде чем применять криптографию.

Здесь можно скачать пакет, реализующий всю магию, а здесь находится код, который рассматривается в статье.
Читать полностью »

Как я решал соревнование по машинному обучению data-like - 1

Привет. Недавно прошло соревнование от Тинькофф и McKinsey. Конкурс проходил в два этапа: первый — отборочный, в kaggle формате, т.е. отсылаешь предсказания — получаешь оценку качества предсказания; побеждает тот, у кого лучше оценка. Второй — онсайт хакатон в Москве, на который проходит топ 20 команд первого этапа. В этой статье я расскажу об отборочном этапе, где мне удалось занять первое место и выиграть макбук. Команда на лидерборде называлась "дети Лёши".

Соревнование проходило с 19 сентября до 12 октября. Я начал решать ровно за неделю до конца и решал почти фулл-тайм.

Краткое описание соревнования:

Летом в банковском приложении Тинькофф появились stories (как в Instagram). На story можно отреагировать лайком, дизлайком, скипнуть или просмотреть до конца. Задача предсказать реакцию пользователя на story.

Соревнование по большей части табличное, но в самих историях есть текст и картинки.

Читать полностью »

Перевод статьи подготовлен специально для студентов курса «Machine learning».


Оптимизация стратегии игры в Блэкджек методом Монте-Карло - 1

Обучение с подкреплением штурмом взяло мир Искусственного Интеллекта. Начиная от AlphaGo и AlphaStar, все большее число видов деятельности, в которых раньше доминировал человек, теперь завоевано агентами ИИ, работающими на основе обучения с подкреплением. Короче говоря, эти достижения зависят от оптимизации действий агента в определенной среде для достижения максимального вознаграждения. В последних нескольких статьях от GradientCrescent мы рассмотрели различные фундаментальные аспекты обучения с подкреплением, от основ систем с бандитами и подходов, основанных на политике, до оптимизации поведения на основе вознаграждения в Марковских средах. Все эти подходы требовали полных знаний о нашей среде. Динамическое программирование, например, требует, чтобы мы обладали полным распределением вероятностей всех возможных переходов состояний. Однако в действительности мы обнаруживаем, что большинство систем невозможно интерпретировать полностью, и что распределения вероятностей не могут быть получены в явном виде из-за сложности, врожденной неопределенности или ограничений вычислительных возможностей. В качестве аналогии рассмотрим задачу метеоролога – число факторов, участвующих в прогнозировании погоды, может быть настолько велико, что точно вычислить вероятность оказывается невозможным.Читать полностью »

Эксплуатация машинного обучения в Почте Mail.ru - 1

По мотивам моих выступлений на Highload++ и DataFest Minsk 2019 г.

Для многих сегодня почта является неотъемлемой частью жизни в сети. С ее помощью мы ведем бизнес-переписку, храним всевозможную важную информацию, связанную с финансами, бронированием отелей, оформлением заказов и многим другим. В середине 2018 года мы сформулировали продуктовую стратегию развития почты. Какой же должна быть современная почта?

Почта обязана быть умной, то есть помогать пользователям ориентироваться в увеличивающемся объеме информации: фильтровать, структурировать и предоставлять ее наиболее удобным способом. Она должна быть полезной, позволяя прямо в почтовом ящике решать различные задачи, например, оплачивать штрафы (функция, которой я, к своему сожалению, пользуюсь). И при этом, разумеется, почта должна обеспечивать информационную защиту, отсекая спам и защищая от взломов, то есть быть безопасной.
Читать полностью »

Доброго времени суток и мое почтение, читатели !

Предыстория

У нас на работе принято обмениваться интересными находками в командах разработки. На очередной встрече, обсуждая будущее .NET и .NET 5 в частности, мы с коллегами заострили внимание на видении унифицированный платформы с этой картинки:
image
На ней показано, что платформа объединяет DESKTOP, WEB, CLOUD, MOBILE, GAMING, IoT и AI. Мне пришла в голову идея провести беседу в формате небольшого доклада + вопросов/ответов по каждой теме на следующих встречах. Ответственный за ту или иную тему предварительно готовится, вычитывает информацию об основных новшествах, пробует что-то реализовать с помощью выбранной технологии, а затем делится с нами своими мыслями и впечатлениями. В итоге все получают реальный отзыв об инструментарии из проверенного источника из первых уст — очень удобно, учитывая то, что самому попробовать и поштурмить все темы может быть не сподручно, банально руки не дойдут.

Поскольку я некоторое время активно интересуюсь машинным обучением в качестве хобби (и иногда использую для небизнесовых задачек в работе), мне досталась тема AI & ML.NET. В процессе подготовки я наткнулся на замечательные инструменты и материалы, к своему удивлению обнаружил, что про них очень мало информации на Хабре. Ранее в официальном блоге Microsoft писали про релиз ML.Net, и Model Builder в частности. Я бы хотел поделиться тем, как вышел на него и какие получил впечатления от работы с ним. Статья больше про Model Builder, чем про ML в .NET в целом; мы постараемся посмотреть на то, что предлагает MS среднему .NET-разработчику, но глазами подкованного в ML человека. Постараюсь при этом держать баланс между пересказыванием туториала, совсем уж разжевыванием для новичков и описанием деталей для ML-специалистов, которым почему-то потребовалось прийти в .NET.

Читать полностью »

image

Глобальная паутина изо дня в день пополняется статьями о самых популярных, наиболее употребляемых алгоритмах машинного обучения для решения различных задач. Причём основа этих статей, немного изменённая по форме в том или ином месте, кочует от одного исследователя данных к другому. При этом все эти работы объединяет один общепринятый, непреложный постулат: применение того или иного алгоритма машинного обучения зависит от размера и природы имеющихся в распоряжении данных и поставленной задачи.

Вдобавок к этому особо настоявшиеся исследователи данных, делясь своим опытом, подчёркивают: «Выбор метода оценки должен частично зависеть от ваших данных и от того, в чём, по вашему мнению, модель должна быть хороша» («Data Science: инсайдерская информация для новичков. Включая язык R», авторы Кэти О’Нил, Рэйчел Шатт).
Читать полностью »

Недавно прошел ID R&D Voice Antispoofing Challenge, главной задачей которого было создать алгоритм, способный отличить человеческий голос (human) от синтезированной записи (spoof). Я — ML Researcher в Dasha AI и много работаю над распознаванием речи, поэтому и решил поучаствовать. Вместе с командой мы заняли первое место. Под катом я расскажу о новых крутых подходах к обработке звука, а также о сложностях и странностях, с которыми нам пришлось столкнуться.

Что ты такое? Как мы spoof от human отличали — да еще и победили - 1

Читать полностью »

Привет! Представляю вашему вниманию перевод статьи «Don’t Ever Ignore Reinforcement Learning Again» автора Michel Kana, Ph.D.

Обучение с учителем и обучение без учителя — это ещё не все. Все это знают. Начните с OpenAI Gym.

image

Собираетесь победить чемпиона мира по шахматам, нардам или го?

Есть способ, который позволит вам это сделать — обучение с подкреплением.
Читать полностью »

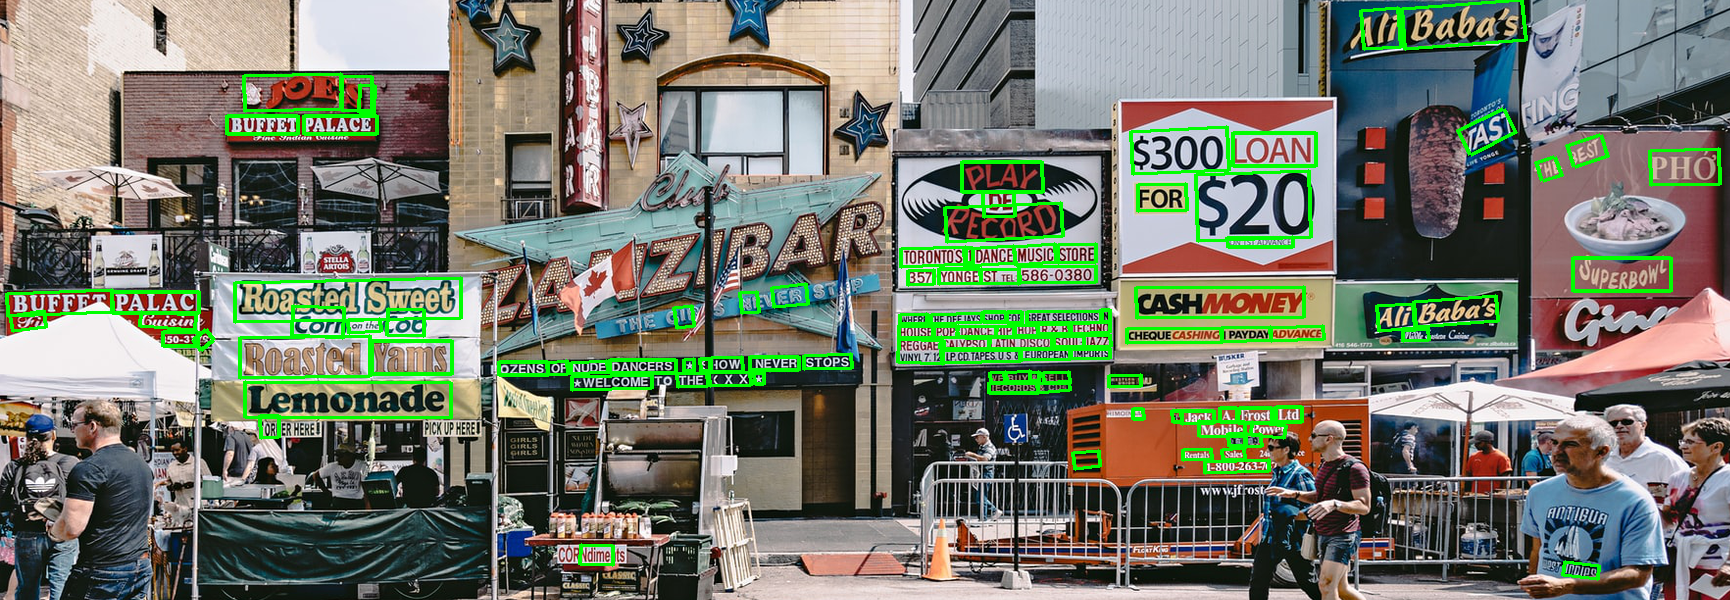
Проблема автоматического поиска текста на изображениях существует достаточно давно, как минимум с начала девяностых годов прошлого века. Они могли запомниться старожилам повсеместным распространением ABBYY FineReader, умеющим переводить сканы документов в их редактируемые варианты.

Сканеры, подключённые к персональным компьютерам, отлично работают в компаниях, но прогресс не стоит на месте, и мир захватили мобильные устройства. Круг задач работы с текстом тоже поменялся. Теперь текст нужно искать не на идеально прямых листах А4 с чёрным текстом на белом фоне, а на различных визитках, красочных меню, вывесках магазинов и много ещё на чём, что человек может встретить в джунглях современного города.

Находим текст на вывесках и упаковках с помощью смартфона - 1
Реальный пример работы нашей нейросети. Картинка кликабельна.

Основные требования и ограничения

При таком разнообразии условий представления текста рукописные алгоритмы уже не справляются. Здесь на помощь нам приходят нейронные сети с их способностью обобщения. В этом посте мы расскажем о нашем подходе к созданию архитектуры нейросети, которая с хорошим качеством и высокой скоростью детектирует текст на сложных изображениях.
Читать полностью »

Перевод статьи подготовлен специально для студентов базового и продвинутого курсов «Математика для Data Science».

Понимаем теорему Байеса - 1


Теорема Байеса – одна из самых известных теорем в статистике и теории вероятности. Даже если вы не работаете с расчетами количественных показателей, вероятно, вам в какой-то момент пришлось познакомиться с этой теоремой во время подготовки к экзамену.

P(A|B) = P(B|A) * P(A)/P(B)

Вот так она выглядит, но что это значит и как работает? Сегодня мы это узнаем и углубимся в теорему Байеса.Читать полностью »


https://ajax.googleapis.com/ajax/libs/jquery/3.4.1/jquery.min.js