Рубрика «machine learning» - 23

Серия «Белый шум рисует черный квадрат»

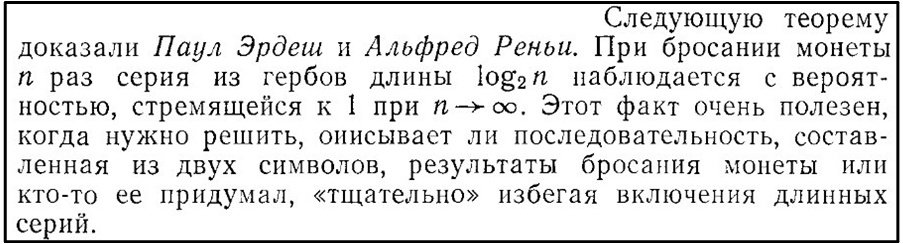
История цикла этих публикаций начинается с того, что в книге Г.Секей «Парадоксы в теории вероятностей и математической статистике» (стр.43), было обнаружено следующее утверждение:
Треугольник Паскаля vs цепочек типа «000…-111…» в бинарных рядах и нейронных сетях - 1
Рис. 1.

По анализу комментарий к первым публикациям (часть 1, часть 2) и последующими рассуждениями созрела идея представить эту теорему в более наглядном виде.

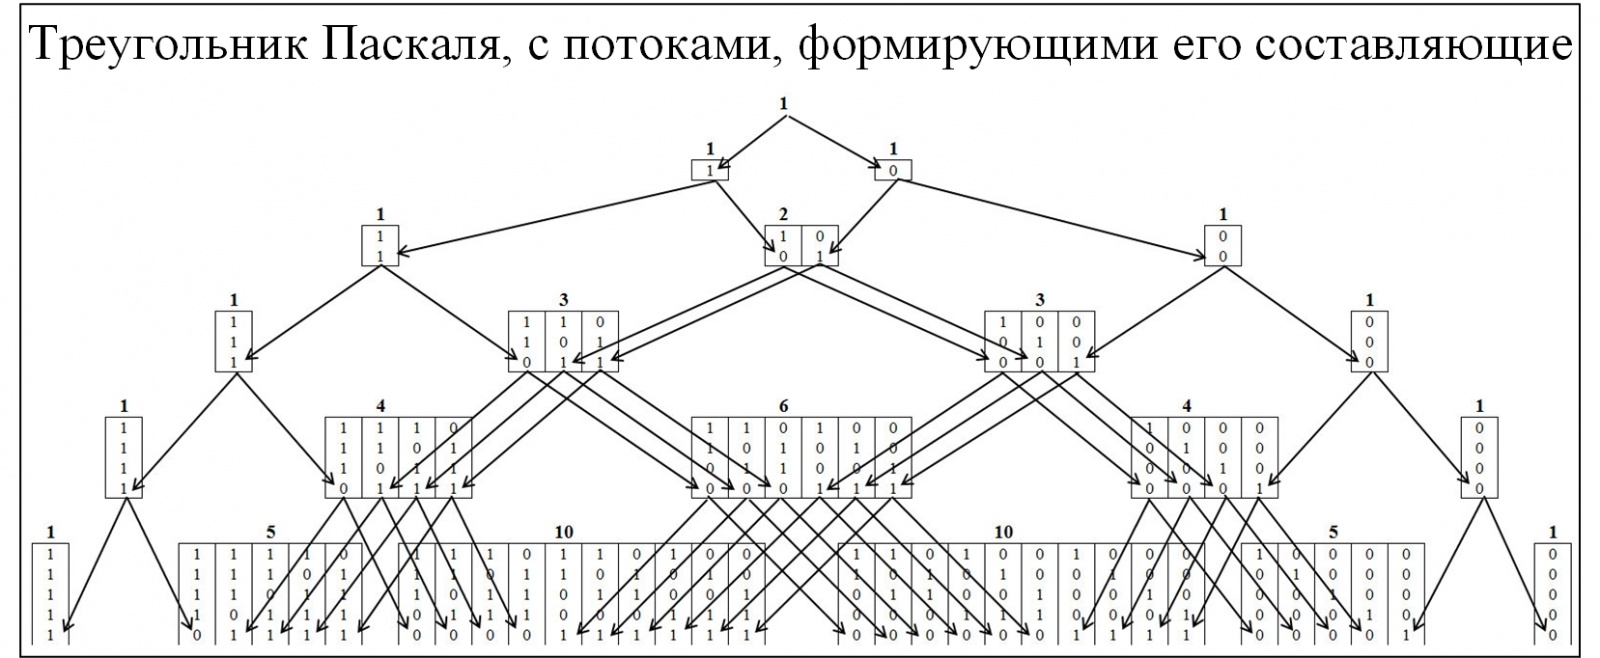
Большинству из участников сообщества знаком треугольник Паскаля, как следствие биноминального распределения вероятностей и многие сопутствующие законы. Для понимания механизма образования треугольника Паскаля развернем его детальнее, с развертыванием потоков его образования. В треугольнике Паскаля узлы формируются по соотношению 0 и 1, рисунок ниже.
Треугольник Паскаля vs цепочек типа «000…-111…» в бинарных рядах и нейронных сетях - 2
Рис. 2.

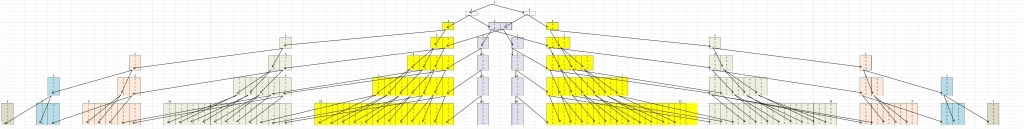
Для понимания теоремы Эрдёша-Реньи составим аналогичную модель, но узлы будут формироваться из значений, в которых присутствуют наибольшие цепочки, состоящие последовательно из одинаковых значений. Кластеризации будет проводиться по следующему правилу: цепочки 01/10, к кластеру «1»; цепочки 00/11, к кластеру «2»; цепочки 000/111, к кластеру «3» и т.д. При этом разобьём пирамиду на две симметричные составляющие рисунок 3.
Треугольник Паскаля vs цепочек типа «000…-111…» в бинарных рядах и нейронных сетях - 3
Рис. 3.

Первое что бросается в глаза это то, что все перемещения происходят из более низкого кластера в более высокий и наоборот быть не может. Это естественно, так как если цепочка размера j сложилась, то она уже не может исчезнуть.
Читать полностью »
image
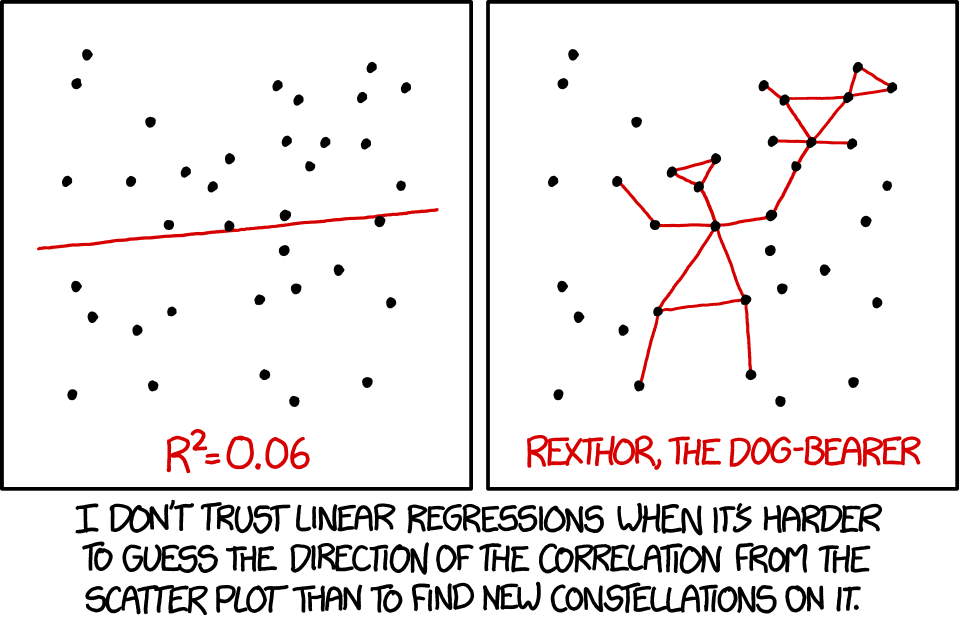
Источник: xkcd

Линейная регрессия является одним из базовых алгоритмов для многих областей, связанных с анализом данных. Причина этому очевидна. Это очень простой и понятный алгоритм, что способствует его широкому применению уже многие десятки, если не сотни, лет. Идея заключается в том, что мы предполагаем линейную зависимость одной переменной от набора других переменных, а потом пытаемся эту зависимость восстановить.

Но в этой статье речь пойдет не про применение линейной регрессии для решения практических задач. Здесь будут рассмотрены интересные особенности реализации распределенных алгоритмов её восстановления, с которыми мы столкнулись при написании модуля машинного обучения в Apache Ignite. Немного базовой математики, основ машинного обучения и распределенных вычислений помогут разобраться, как восстанавливать линейную регрессию, даже если данные распределены между тысячами узлов.
Читать полностью »

Однажды, исследуя глубины интернета, я наткнулся на видео, где человек обучает змейку с помощью генетического алгоритма. И мне захотелось так же. Но просто взять все то же самое и написать на python было бы не интересно. И я решил использовать более современный подход для обучения агентных систем, а именно Q-network. Но начнем с начала.

Обучение с подкреплением

В машинном обучении RL(Reinforcement Learning) достаточно сильно отличается от других направлений. Отличие состоит в том, что классический ML алгоритм обучается уже на готовых данных, в то время как RL, так сказать, сам создает себе эти данные. Идея RL состоит в том, что помимо самого алгоритма, который называют агентом, существует среда(environment), в которую этот агент и помещается. На каждом этапе агент должен совершать какое-то действие(action), а среда отвечает на это наградой(reward) и своим состоянием(state), на основе которого агент и совершает действие.

DQN

Здесь должно быть объяснение того, как алгоритм работает, но я оставлю ссылку на то, где это объясняют умные люди.

Читать полностью »

Всем привет. Считанные дни остаются до старта курса «Machine Learning». В преддверии начала занятий мы подготовили полезный перевод, который будет интересен как нашим студентам, так и всем читателям блога. И сегодня делимся с вами завершающей частью данного перевода.

Интерпретируемая модель машинного обучения. Часть 2 - 1


Partial Dependence Plots

Partial Dependence Plots (графики частичной зависимости или же PDP, PD-графики) показывают незначительное влияние одного или двух признаков на прогнозируемый результат модели машинного обучения ( J. H. Friedman 2001 ). PDP может показать связь между целью и выбранными признаками с помощью 1D или 2D графиков.Читать полностью »

Компьютерное зрение видит эмоции, пульс, дыхание и ложь — но как построить на этом стартап. Разговор с Neurodata Lab - 1

Наши отношения с компьютерным зрением не были такими шумными, пока оно не научилось творить чудеса с человеческими лицами. Алгоритмы подменяют людей на фото и видео, меняют возраст, расу и пол. Это и главное интернет-развлечение последних лет, и источник тревог. Сегодня приложения штурмуют чарты, завтра протестующие пилят столбы с камерами, распознающими лица. И, кажется, мы только в самом начале пути. Того, что компьютер может считать с нашего лица, будет все больше и больше.

В начале месяца мы посетили офис Neurodata Lab. Основное направление для компании — распознавание человеческих эмоций. Мы постарались выяснить как это делается и зачем нужно.

Neurodata Lab получила на «Моём круге» среднюю оценку 4,6 и среднюю рекомендацию 95% от своих сотрудников, которые выше всего оценили такие критерии, как профессиональный рост, интересные задачи, хорошие отношения с коллегами и то, что компания делает мир лучше.

Читать полностью »

Напиши свою песню за 10 минут (модуль textgenrnn Python3) - 1

Сегодня попробуем обучить свою собственную нейронную сеть, чтобы писала текст для песен. Обучающей выборкой будут тексты группы "Руки Вверх". Ничто не мешает чтобы поменять данные на тексты своих любимых групп. Для извлечения данных с веб-сайтов используем Python3 (модуль BeautifulSoup).

Задача будет состоять в том, чтобы выгрузить данные(тексты) c веб-сайтов а потом на их основе обучить нейронную сеть.

На самом деле, можно разбить работу на 2 этапа:
Этап 1: выгрузить и сохранить тексты песни в удобном формате.
Этап 2: обучить свою собственную нейронную сеть.

Читать полностью »

image

31 августа 2019г. Mail.ru Group и сообщество Open Data Science приглашают на Moscow Data Science Major. Это как Data Fest, только мини. Событие состоит из 8 тематических блоков докладов, 1 ML-тренировки и 8 часов ударной порции нетворкинга и знакомств. Знакомьтесь с программой и регистрируйтесь! Вход на событие бесплатный, по одобренной регистрации. Регистрация закрывается в 29 августа в 12:00.
Читать полностью »

Сделал подборку книг по Machine Learning для тех, кто хочет разобраться, что да как.
Добавляйте в закладки и делитесь с коллегами!

Книги по машинному обучению на русском

1. «Математические основы машинного обучения и прогнозирования» Владимир Вьюгин.

О чем

Сначала изучите азы статистической теории машинного обучения, игр с предсказаниями и прогнозирования с применением экспертной стратегии. Их основы прекрасно объясняет автор книги, доктор физико-математических наук Владимир Вьюгин. Пособие рассчитано на студентов и аспирантов и в доступной форме излагает математические основы, необходимые для дальнейшей работы с машинным обучением.

2. «Верховный алгоритм» Педро Домингос.

О чем

Книга, благодаря которой даже ничего не смыслящие в математике и статистике люди поймут, что такое алгоритмы машинного обучения и каково их применение в жизни. Профессор Педро Домингос рассказывает о пяти основных школах Machine Learning и о том, как они используют идеи из различных областей научного знания — нейробиологии, физики, статистики, биологии, — чтобы помогать людям решать сложные задачи и упрощать рутину с помощью алгоритмов.
Читать полностью »

Не секрет, что ученые очень любят исследовать мир. Поэтому крупные конференции всегда проходят в исторических и культурных столицах мира. Эти города удобны для посещения людям со всего мира и интересны с туристической точки зрения. Но иногда желание исследовать новое и неизведанное берет верх, и городом проведения конференции становится, например, Анкоридж на Аляске. Тоже о нем не слышали до этого? А в этом году там проходила одна из крупнейших конференций KDD'19.

Трип на Аляску, или KDD'19 глазами очевидца - 1

Мы в компании Антиплагиат не могли пропустить такое событие и отправились навстречу приключениям на другой конец земного шара. Что было на KDD 2019 — читайте в нашем обзоре!

Читать полностью »

В первой публикации рассказывалось о том, что есть подзабытая теорема Эрдёша-Реньи, из которой следует, что в случайном ряде, длины N, с вероятностью близкой к 1 существует подряд из одинаковых значений длиной log_2{N}. Указанное свойство случайной величины можно использовать для ответа на вопрос: «После обработки больших данных, подчиняется ли остаточный ряд закону случайных чисел или нет?»

Ответ на такой вопрос определялся не на основании тестов соответствия нормальности распределения, а на основании свойств самого остаточного ряда.
Читать полностью »


https://ajax.googleapis.com/ajax/libs/jquery/3.4.1/jquery.min.js