Рубрика «open source» - 96

Ну, если под любимым языком подразумевается русский, английский и т. д., то это в другой хаб. А если язык программирования или разметки, то конечно писать анализатор самим! На первый взгляд, это очень сложно, но, к счастью, существуют готовые многоязыковые инструменты, в которые относительно легко добавить поддержку нового языка. Сегодня я покажу, как можно с достаточно незначительными затратами времени добавить поддержку языка Modelica в анализатор PMD.

Кстати, знаете, что может ухудшить качество кодовой базы, полученной из последовательности идеальных pull request-ов? Тот факт, что сторонние программисты копировали в свои патчи куски существующего кода проекта вместо грамотного абстрагирования. Согласитесь, в какой-то мере такую банальность отловить ещё сложнее, чем некачественный код — он же качественный и даже уже тщательно отлаженный, поэтому тут недостаточно локальной проверки, нужно держать в голове всю кодовую базу, а человеку это непросто… Так вот: если на добавление полной поддержки Modelica (без создания конкретных правил) до состояния «может запускать примитивные проверки» у меня ушло около недели, то поддержку только copy-paste detector часто можно вообще добавить за день!

Читать полностью »

Команда Rust рада сообщить о выпуске новой версии, 1.39.0. Rust — это язык программирования, позволяющий каждому создавать надёжное и эффективное программное обеспечение.

Если вы установили предыдущую версию Rust средствами rustup, то для обновления до версии 1.39.0 вам достаточно выполнить следующую команду:

$ rustup update stable

Если у вас ещё не установлен rustup, вы можете установить его с соответствующей страницы нашего веб-сайта, а также посмотреть подробные примечания к выпуску на GitHub.

Что вошло в стабильную версию 1.39.0

Наиболее существенные нововведения включают в себя синтаксис async/.await, разделяемые ссылки к перемещаемым значениям в match-guards и атрибуты у параметров функций. Смотрите подробные примечания к выпуску для дополнительной информации.

Читать полностью »

В статическом анализаторе NoVerify появилась киллер-фича: декларативный способ описания инспекций, который не требует программирования на Go и компиляции кода.

Чтобы вас заинтриговать, покажу описание простой, но полезной инспекции:

/** @warning duplicated sub-expressions inside boolean expression */
$x && $x;

Эта инспекция находит все выражения логического &&, где левый и правый операнд идентичны.

NoVerify — статический анализатор для PHP, написанный на Go. Почитать о нём можно в статье «NoVerify: линтер для PHP от Команды ВКонтакте». А в этом обзоре я расскажу о новой функциональности и том, как мы к ней пришли.

Как добавить проверки в NoVerify, не написав ни строчки Go-кода - 1

Читать полностью »

image

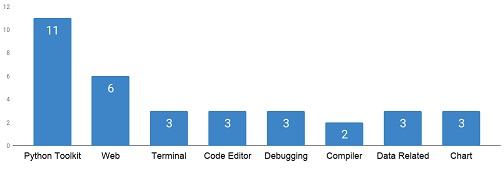
Мы просмотрели и сравнили 10 000 open source библиотек для Python и выбрали 34 самые полезные.

image

Мы сгруппировали эти библиотеки в 8 категорий.
Читать полностью »

Доброго ноября, дамы и господа. Подготовил для вас подборку самых интересных находок из опенсорса за октябрь 2019.

За полным списком новых полезных инструментов, статей и докладов можно обратиться в мой телеграм канал @OpensourceFindings (по ссылке зеркало, если не открывается оригинал).

В сегодняшнем выпуске.
Технологии внутри: Rust, Swift, TypeScript, JavaScript, Go, Scala, Python.
Тематика: веб и мобильная разработка, визуализация данных, инструменты разработчика, документация.

Прошлый выпуск.

Читать полностью »

Всем привет! Несколько месяцев назад мы запустили в продакшн наш новый open-source проект — Grafana-плагин для мониторинга kubernetes, который назвали DevOpsProdigy KubeGraf. Исходный код плагина доступен в публичном репозитории на GitHub. А в этой статье мы хотим поделиться с вами историей о том, как мы создавали плагин, какие инструменты использовали и с какими подводными камнями столкнулись в процессе разработки. Погнали!
Читать полностью »

image

В начале этого года по ряду причин мы загорелись идеей создать самый большой открытый датасет русской речи. Подробнее о нашей мотивации и о том, как всё начиналось,
можно прочитать в этой статье — Огромный открытый датасет русской речи. С тех пор наш проект прошел через ряд масштабных изменений, мы в три раза увеличили количество данных, повысили их качество, добавили лейблы для спикеров и сейчас мы наконец готовы представить вам версию 1.0.

Также мы не готовы останавливаться на достигнутом и планируем продолжать делать интесивную работу над ошибками в последующих версиях и улучшать качество уже опубликованных данных. Версию 1.1 мы планируем посвятить масштабной работе над ошибками.

Читать полностью »

На данный момент LLVM стала уже очень популярной системой, которую многие активно используют для создания различных компиляторов, анализаторов и т.п. Уже написано большое количество полезных материалов по данной тематике, в том числе и на русском языке, что не может не радовать. Однако в большинстве случаев основной уклон в статьях сделан на frontend и middleend LLVM. Конечно, при описании полной схемы работы LLVM генерация машинного кода не обходится стороной, но в основном данной темы касаются вскользь, особенно в публикациях на русском языке. А при этом у LLVM достаточно гибкий и интересный механизм описания архитектур процессоров. Поэтому данный материал будет посвящен несколько обделенной вниманием утилите TableGen, входящей в состав LLVM.

Причина, по которой компилятору необходимо иметь информацию об архитектуре каждой из целевых платформ вполне очевидна. Естественно, у каждой модели процессора свой набор регистров, свои машинные инструкции и т.д. И компилятору нужно иметь всю необходимую информацию о них, чтобы быть в состоянии генерировать валидный и эффективный машинный код. Компилятор решает различные платформенно-зависимые задачи: производит распределение регистров и т.д. К тому же в бэкендах LLVM также проводятся оптимизации уже на машинном IR, который больше приближен к реальным инструкциям, или же на самих ассемблерных командах. В подобных оптимизациях нужно заменять и преобразовывать инструкции, соответственно вся информация о них должна быть доступна.
Читать полностью »

Мне действительно нравится уровень безопасности, предоставляемый U2F, но вместе с безопасностью, необходимо продумать и план восстановления. Потеря доступа к своим самым важным аккаунтам, если с основным U2F токеном что-то случится — серьезная проблема. В то же время, хотелось бы избежать использования бэкапа, который ставит под угрозу безопасность, предоставляемую U2F.

yubikey

Популярные методы бэкапа

На сегодняшний день, образцовая практика — держать второй независимый U2F токен для бэкапа; этот токен должен быть добавлен вручную на каждый сервис и храниться в «безопасном» месте. Другая общепринятая практика — использовать не-U2F метод в качестве бэкапа (OTP, коды восстановления). Честно говоря, оба этих метода оставляют желать лучшего.

Читать полностью »

Привет! Представляю вашему вниманию перевод статьи «An Open Source License That Requires Users to Do No Harm» автора Klint Finley.

Лицензия для проектов с открытым исходным кодом, которая обязывает пользователей «не причинять вред» - 1

Китай использует технологии распознавания лиц, чтобы вычислять уйгурских мусульман. Военные США используют дроны для убийства подозреваемых в терроризме, а заодно и находящихся поблизости гражданских. Иммиграционная и таможенная полиция США — те самые которые держали детей в клетках рядом с мексиканской границей — полагаются на софт для коммуникации и координации, как и все современные организации.Читать полностью »


https://ajax.googleapis.com/ajax/libs/jquery/3.4.1/jquery.min.js