

Недавно я читала материалы о сжатии данных, и меня внезапно озарила безумная мысль: по сути своей, алгоритмы сжатия и LLM предназначены для решения одной и той же задачи.
Недавно я читала материалы о сжатии данных, и меня внезапно озарила безумная мысль: по сути своей, алгоритмы сжатия и LLM предназначены для решения одной и той же задачи.
a.
$ echo "aaaaaaaa" > test.out
$ xxd test.out
00000000: 6161 6161 6161 6161 0a     aaaaaaaa.
Файл получился размером 9 байт — 8 символов a плюс перевод каретки в конце.
Теперь упакуем его. Сделаем это командой gzip -1, поскольку так мы задействуем самый быстрый метод сжатия, который позволит нам лучше разобрать процесс.
$ gzip -1 test.out
$ xxd test.out.gz
00000000: 1f8b 0808 bf35 6a61 0403 7465 7374 2e6f  .....5ja..test.o
00000010: 7574 004b 4c84 002e 00b6 66d7 ad09 0000  ut.KL.....f.....
00000020: 00Дисклеймер: эту статью я писал в целях обучения, так что мог допустить некоторые ошибки. Мне нравится заниматься низкоуровневым программированием, но моя основная деятельность сосредоточена на веб-разработке для Microsoft Teams.
Возьмём классический пример — реестр Windows. Этот странный артефакт инженерной мысли представляет некое подобие иерархической БД для хранения абсолютно всех настроек — и системных, и приложений, и драйверов. Центральное бинарное хранилище заменило массу файлов .ini, разбросанных по всей системе и должно было упростить жизнь. Но вышло наоборот. И глядя на монструозный тормозящий конструкт, возникает только один вопрос: как это исправить? Ответ тоже простой: «Если вкратце, то никак». И так во всём. Мы создаём монстров, а потом не можем от них избавиться.
Читать полностью »
tl;dr Я бы сказал, что Microsoft на несколько световых лет опередила всех в разработке инструментов для проектирования сложных веб-сайтов. Сейчас эти технологии изобретают заново на руинах погибшей цивилизации.
Когда я был ребёнком, меня всегда завораживали истории о древних цивилизациях. Я зачитывался книгами об Атлантиде, об истории открытия Трои Генрихом Шлиманом, о греках, римлянах, империи инков и Древнем Египте. И меня всегда восхищали их продвинутые знания в области астрономии, математики и медицины, их невероятные достижения, возведение этих огромных монументов и построение высокофункциональных социальных систем. Что ещё более невероятно, так это то, что всё это было сделано за тысячи лет до появления христианской культуры!
Однако все эти высокоразвитые цивилизации в конце концов исчезли. Некоторые просто тихо вымерли, других вытеснили цивилизациями с лучшим вооружением. В большинстве случаев достижения побеждённых не передавались доминирующей группе, никак не обогащая победителей. Они просто исчезали. Что я всегда считал неудачным развитием событием.
Читать полностью »
В данной статье будет проведено сравнение средств резервного копирования, но сначала стоит узнать, как они быстро и хорошо справляются с восстановлением данных из резервных копий.
Для простоты сравнения будет рассматриваться восстановление из полной резервной копии, тем более что данный режим работы поддерживают все кандидаты. Для простоты цифры взяты уже усредненными (среднее арифметическое из нескольких запусков). Результаты будут сведены в таблицу, в которой также будет информация и о возможностях: наличие веб-интерфейса, простота в настройке и работе, способность к автоматизации, наличие различных дополнительных возможностей (к примеру, проверка целостности данных) и т.п. Графики будут показывать загрузку сервера, где данные и будут применяться (не сервера для хранения резервных копий).
Читать полностью »
Не так давно в Яндекс приезжал Геннадий Пехименко — профессор Университета Торонто и PhD Университета Карнеги-Меллон. Он прочитал лекцию об алгоритмах кодирования, которые позволяют обходить проблему ограничения памяти GPU при обучении глубоких нейронных сетей.
— Я вхожу в несколько групп Университета Торонто. Одна из них — Computer Systems and Networking Group. Есть еще моя собственная группа — EcoSystem Group. Как видно из названий групп, я не специалист непосредственно в машинном обучении. Но нейронные сети сейчас достаточно популярны, и людям, которые занимаются компьютерной архитектурой и сетями, компьютерными системами, приходится сталкиваться с этими приложениями на постоянной основе. Поэтому последние полтора-два года этой темой я тоже плотно занимаюсь.
Читать полностью »
Ускорить доставку элементов фронтенда на устройство пользователя можно несколькими способами. Разработчик Артём Белов из самарского офиса норвежской компании Cxense попробовал самые многообещающие: HTTP/2, Server Push, Service Worker, а также оптимизацию в процессе сборки и на стороне клиента. Итак, что же нужно сделать, чтобы сократить время отклика приложения до минимума?
Выясняется, что алгоритмы сжатия существуют уже давно. Это произошло где-то в июне — видимо, где-то над Самарой пролетал метеорит и идея проверить новые алгоритмы сжатия, Zopfli и Brotli, пришла мне и парню из соседней компании. Больше чем уверен, вы читали его статью, это Александр Субботин. Статья разошлась на Medium, и он известен, а я нет.
По мере того как наши сайты всё сильнее зависят от JavaScript, приходится расплачиваться за то, что мы отправляем пользователям, и иногда эта цена не видна с первого взгляда. В этой статье я объясню, почему полезно проявить немного дисциплины, если вы хотите ускорить загрузку и производительность на мобильных устройствах.
tl;dr: меньше кода = меньше парсинг/компиляция + меньше передача + меньше распаковка
Когда большинство разработчиков думают о расходах на JavaScript, они размышляют о времени скачивания и выполнения. Отправка большего количества байт JavaScript занимает тем больше времени, чем тоньше канал с пользователем.
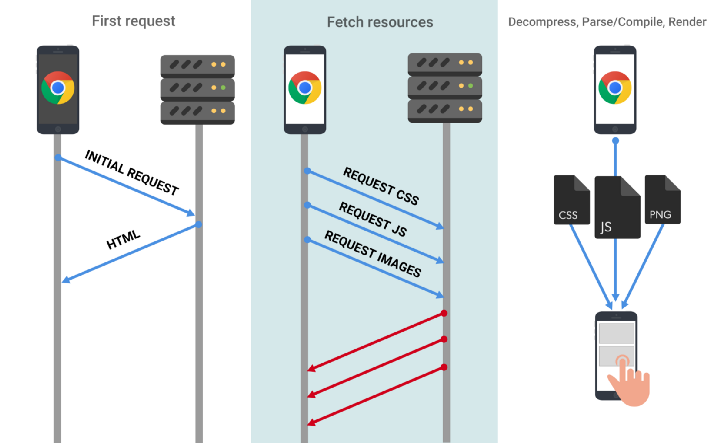
Это может стать проблемой даже в странах первого мира, поскольку эффективный тип сетевого соединения у пользователя необязательно 3G, 4G или WiFi. Вы можете сидеть в кафе с WiFi, но быть подключённым к хотспоту через сотовую связь со скоростью 2G.
Читать полностью »
Проблема — в часы пик не справляется сетевой интерфейс с передаваемым объёмом данных.
Из доступных вариантов решения был выбран сжатие хранимых данных
tl;dr: экономия памяти >100% и сети >50%. Речь пойдёт о плагине для predis, который автоматически сжимает данные перед отправкой в redis.
Читать полностью »
 [Обновление] Теперь я в каком-то списке спецслужб, потому что написал статью про некий вид «бомбы», так?
Если вы когда-нибудь хостили веб-сайт или администрировали сервер, то наверняка хорошо знаете о плохих людях, которые пытаются сделать разные плохие вещи с вашей собственностью.
Когда я в возрасте 13 лет впервые захостил свою маленькую Linux-коробочку с доступом по SSH, я смотрел логи и каждый день видел IP-адреса (в основном, из Китая и России), которые пытались подключиться к моей сладенькой маленькой коробочке (которая на самом деле была старым ноутом ThinkPad T21 со сломанным дисплеем, жужжавшим под кроватью). Я сообщал эти IP их провайдерам.
На самом деле если у вас Linux-сервер с открытым SSH, то можете сами посмотреть, сколько попыток подключений происходит ежедневно:
grep 'authentication failures' /var/log/auth.log