Мы продолжаем цикл задач, где рассказыаем, как работать с генетическими данными. Первую задачу «Узнайте пол и степень родства» уже можно решить и прислать нам ответы. Сегодня публикуем вторую.
Главный приз — Полный геном.
Мы продолжаем цикл задач, где рассказыаем, как работать с генетическими данными. Первую задачу «Узнайте пол и степень родства» уже можно решить и прислать нам ответы. Сегодня публикуем вторую.
Главный приз — Полный геном.
Перед вами перевод статьи из блога Seattle Data Guy. В ней авторы выделили 5 наиболее популярных ресурсов для обработки Big Data на текущий момент.
Сегодня любая компания, независимо от ее размера и местоположения, так или иначе имеет дело с данными. Использование информации в качестве ценного ресурса, в свою очередь, подразумевает применение специальных инструментов для анализа ключевых показателей деятельности компании. Спрос на аналитику растет пропорционально ее значимости, и уже сейчас можно определить мировые тенденции и перспективы в этом секторе. Согласно мнению International Data Corporation, в 2019 году рынок Big Data и аналитики готов перешагнуть порог в 189,1 миллиарда долларов.Читать полностью »
Я мирно сидел на семинаре, слушал доклад студента о статье с прошлого CVPR и параллельно гуглил тему.
— К достоинствам статьи можно отнести наличие исходного кода….
Пришлось вмешаться:
— Наличие чего, простите?
— Э-э-э… Исходного кода…
— Вы его смотрели?
— Нет, но в статье указано…
(мать-мать-мать… привычно отозвалось эхо)
ㅡ Вы ходили по ссылке?
В статье, действительно, предельно обнадеживающе написано: “The code and model are publicly available on the project page …/github.io/...”, — однако в коммите двухлетней давности по ссылке значится вдохновляющее «Код и модель скоро выложим»:
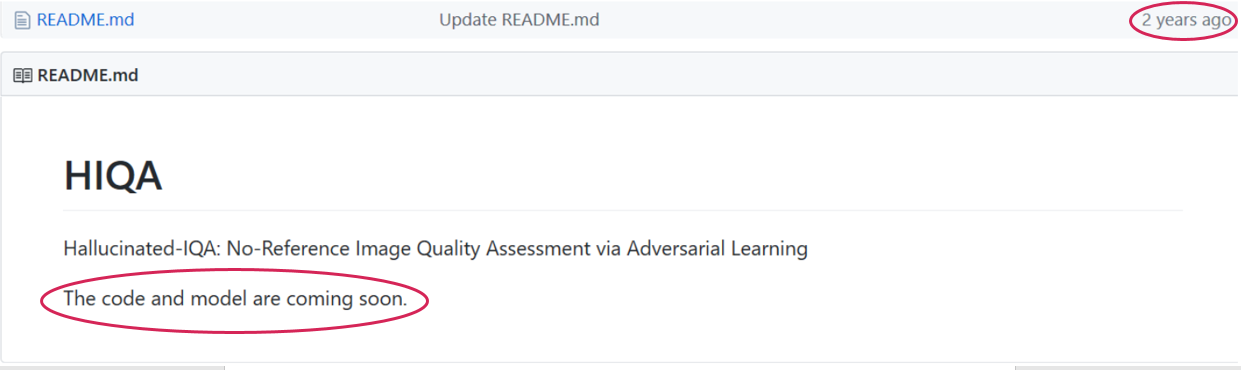 Ищите и обрящете, стучите и откроется… Может быть… А может быть и нет. Я бы, исходя из печального опыта, ставил на второе, поскольку ситуация в последнее время повторяется ну уж о-о-очень часто. Даже на CVPR. И это только часть проблемы! Исходники могут быть доступны, но, к примеру, только модель, без скриптов обучения. А могут быть и скрипты обучения, но за несколько месяцев с письмами к авторам не получается получить такой же результат. Или за год на другом датасете с регулярными скайп-звонками автору в США не удается воспроизвести его результат, полученный в наиболее известной лаборатории в отрасли по этой теме… Трындец какой-то.
И, судя по всему, мы пока видим лишь цветочки. В ближайшее время ситуация кардинально ухудшится.
Кому интересно, что стало со студентом куда катится научный мир, в том числе по «вине» глубокого обучения, добро пожаловать под кат!
Читать полностью »
Привет! Меня зовут Максим Пчелин, и я руковожу разработкой BI-DWH в MyGames (игровое подразделение Mail.ru Group). В этой статье я расскажу о том, как и зачем мы строили клиентоориентированное DataLake-хранилище.
Статья состоит из трех частей. Сперва я расскажу, почему мы решили реализовывать DataLake. Во второй части я опишу, какие технологии и решения мы используем, чтобы хранилище могло работать и наполняться данными. И в третьей части опишу, что мы делаем для улучшения качества наших сервисов.
Читать полностью »
Привет! Отфильтровав для вас большое количество источников и подписок, сегодня собрал все наиболее значимые новости из мира будущего, машинного обучения, роботов и искусственного интеллекта за ноябрь. Не забудьте поделиться с коллегами или просто с теми, кому интересны такие новости.
Для тех, кто не читал дайджест за октябрь, можете прочесть его здесь.
Итак, а теперь дайджест за ноябрь:
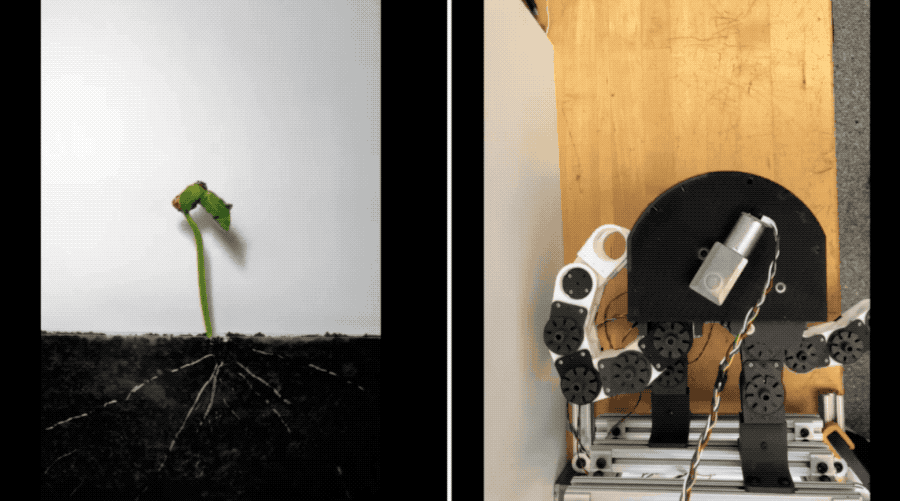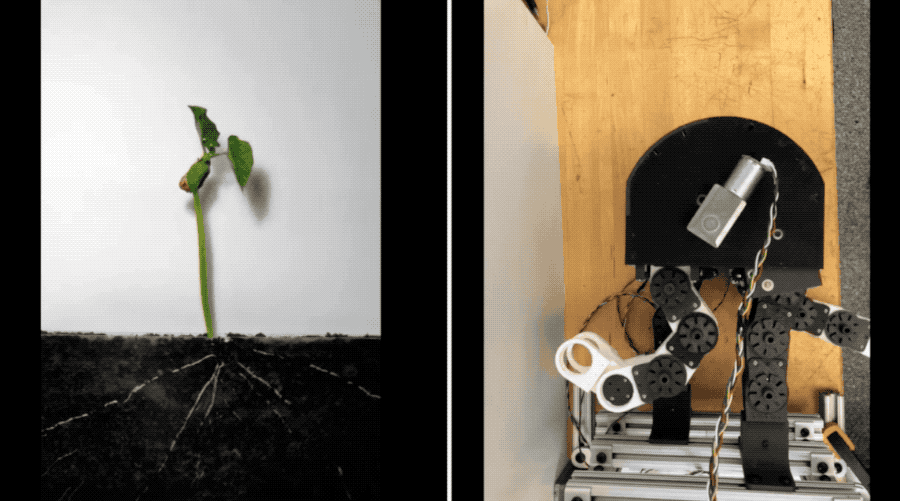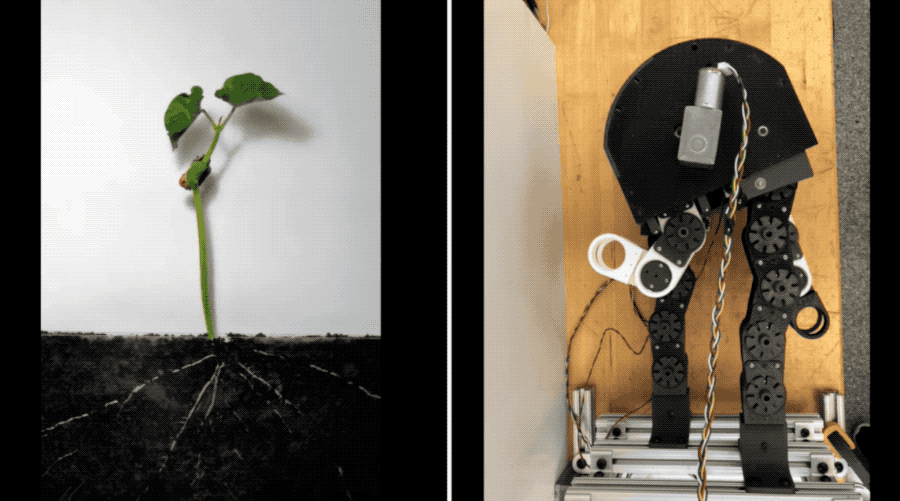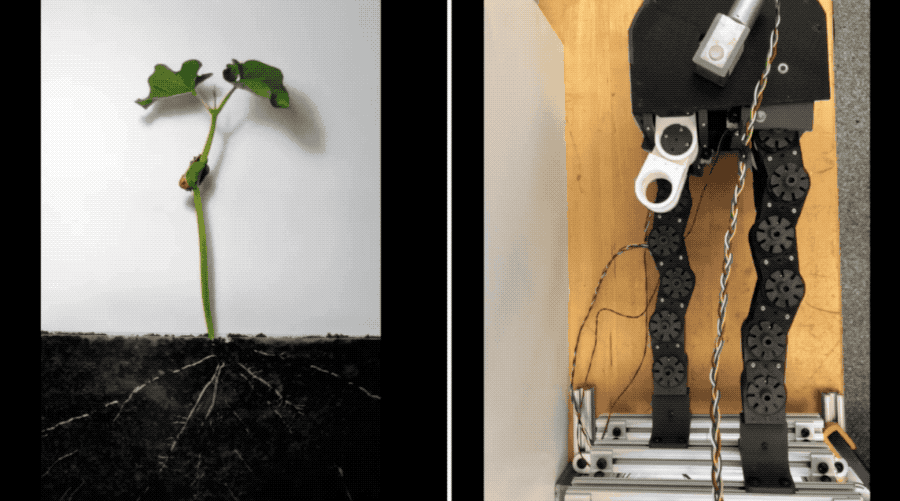
1. MIT разработал новый тип робота, который может расти как растение когда ему требуется дополнительная досягаемость.
Технологии Big Data применяются сейчас повсеместно — в промышленности, медицине, бизнесе, развлечениях. Так, без анализа больших данных не смогут нормально работать крупные ритейлеры, упадут продажи в Amazon, будут не в состоянии предсказывать погоду на многие дни, недели и месяцы наперед метеорологи. Логично, что специалисты по большим данным сейчас нарасхват, причем спрос постоянно растет.
Читать полностью »
Самые большие телеком-компании нашей страны давно перестали считать себя исключительно телеком-компаниями — теперь это одни из главных игроков ИТ-индустрии. Они вынуждены меняться потому что меняется мир. Телефоны в нем называются телефонами по традиции, и функцию звонков туда добавляют, кажется, только по привычке. День, когда выйдет телефон без возможности «позвонить голосом», никто и не заметит.
Операторы соревнуются скоростью интернета больше, чем качеством звонков. Они придумывают новые и новые виды услуг — а самое главное очень много вкладывают в исследование данных.
Маленькие стартапы, которые ищут дата-саентистов, жалуются, что предложения больших корпораций не перебить. Причем не только денежные — просто такого количества данных и масштаба задач, как у телеком-операторов, мало где еще можно найти.
В этом выпуске мы поговорили с сотрудниками отдела больших данных в МегаФоне — что они делают, какие используют инструменты и как нанимают людей. Кстати, судя по оценке на «Моём круге», сотрудники ценят МегаФон за комфортные условия труда, интересные задачи, современность используемых в работе технологий и за отличные отношения в коллективе. Читать полностью »
Если вспомнить практику анализа данных 10 лет назад и сравнить её с тем, что есть сейчас, то станет очевидно —за декаду Data Science проделал гигантский путь. Компьютерное зрение, рекомендательные системы, большие данные, искусственный интеллект — в 2010 эти слова использовались в основном только передовыми ИТ-компаниями. Никто не мог представить, что всего лишь за 10 лет эти технологии изменят мир.
Каким бы был Netflix без рекомендательной системы? Кто будет подсказывать какие сериальчики смотреть по вечерам. Или Apple music, в котором вам ничего не рассказывают про новые альбомы в стиле христианский блэк-метал? Только подумайте сколько времени займет выдача кредита без применения скоринговой системы? Представьте себе YouTube, который ничего не показывает в разделе «Рекомендованные видео». Хотя… при таком сценарии я бы больше спал, а не смотрел смешные видосы про котов до 3-х часов ночи. Мир ждет, что водителей заменят беспилотные автомобили, хотя в 2010 это было научной фантастикой. Да чего там, Tinder подбирает пары на основе алгоритмов машинного обучения, люди женятся, у них рождаются дети, если призадуматься, то окажется, что фактически это дети искусственного интеллекта Sic.
Мы многим обязаны Data Science, поэтому 16 декабря в московском офисе Одноклассников соберемся и вместе с коллегами из OK, Сбербанка, VK и X5 Retail Group проведем ок.tech: Data Толк #4 новогодний выпуск. Поговорим про итоги года и десятилетия в области анализа и обработки данных. Какой была индустрия раньше, что она представляет сейчас и какие сюрпризы нас ждут в будущем, когда Илон Маск заменит людей огромными человекоподобными роботами. Ответы на все эти вопросы вы получите на нашем мероприятии.
Приходите! Будет полезно, интересно и весело!
Зарегистрироваться на мероприятие.
Под катом вас ждут описания докладов и расписание.
Читать полностью »
В современном мире сложно представить развитие продукта без A/B-тестирования. Чтобы успешно запустить продукт или новую функциональность — надо грамотно спроектировать A/B, рассчитать и интерпретировать его результаты. Иногда нам требуется тестирование более чем для двух групп. В этой статье мы рассмотрим как раз такой случай — множественное тестирование:
Итак, приступим.
По мотивам моих выступлений на Highload++ и DataFest Minsk 2019 г.
Для многих сегодня почта является неотъемлемой частью жизни в сети. С ее помощью мы ведем бизнес-переписку, храним всевозможную важную информацию, связанную с финансами, бронированием отелей, оформлением заказов и многим другим. В середине 2018 года мы сформулировали продуктовую стратегию развития почты. Какой же должна быть современная почта?
Почта обязана быть умной, то есть помогать пользователям ориентироваться в увеличивающемся объеме информации: фильтровать, структурировать и предоставлять ее наиболее удобным способом. Она должна быть полезной, позволяя прямо в почтовом ящике решать различные задачи, например, оплачивать штрафы (функция, которой я, к своему сожалению, пользуюсь). И при этом, разумеется, почта должна обеспечивать информационную защиту, отсекая спам и защищая от взломов, то есть быть безопасной.
Читать полностью »