Рубрика «открытые данные» - 8

Многие из тех, кто работает с государственными заказчиками или непосредственно в государственных структурах, наверняка сталкивались с Единым реестром российского программного обеспечения для электронных вычислительных машин и баз данных. Реестр создан на основании широкого известного в узких кругах Постановления Правительства Российской Федерации от 16.11.2015 «Об установлении запрета на допуск программного обеспечения, происходящего из иностранных государств, для целей осуществления закупок для обеспечения государственных и муниципальных нужд».

Можно долго дискутировать, положительно или отрицательно влияет Реестр на развитие отечественного ПО, но все государственные органы обязаны использовать только ПО, входящее в Реестр, либо же обосновывать невозможность соблюдения запрета на допуск иностранного ПО. Наверняка закупки винды, майкрософт офисов и прочих ораклов и айбиэмов будут продолжаться еще очень и очень долго. Однако, потихоньку возникают российские операционные системы типа Альт Линукса, Астра Линукса или ОС Роса, пробиваются ростки офисных пакетов, отечественных блокчейнов . Возникают российские СУБД от достаточно известных ClickHouse или Линтер до абсолютно безвестных разработок. Ну и конечно же не может не быть отечественной Джавы. Чтобы снять возможные вопросы или споры, оговорюсь, что указанное выше ПО, названо в статье российским исходя из факта его вхождения в Реестр, более детальное изучение данного вопроса каждый может провести сам.

Так вот, Реестр функционирует уже почти 4 года и согласно пункту 37 Порядка его ведения сведения, хранящиеся в нем являются открытыми и общедоступными. Ну а если эти сведения открыты и общедоступны, то почему бы не проанализировать их?

В статье приведена небольшая статистика по Единому реестру российского программного обеспечения для электронных вычислительных машин и баз данных. Если вам стало интересно, прошу под кат.
Читать полностью »

Как наладить поиск адреса по координатам (и где взять нужный справочник) - 1

Весной мы добавили в API DaData.ru фичу «Обратное геокодирование», она же «Адрес по координатам». Название намекает: метод принимает геокоординаты и отдает данные об адресе.

Солидный продукт с той же функциональностью сделал «Яндекс» — он называется «Геокодер». Но сервис «Яндекса» бесплатен только для открытых некоммерческих проектов. Стандартный же тариф — от 120 000 ₽ в год — подходит не всем.

Мы подумали — если сделать бесплатную или недорогую альтернативу, разработчики наверняка скажут спасибо. И сделали, благо подготовили к тому времени сильные стартовые позиции:

  • Справочник адресов с координатами, собранный и проверенный собственноручно.
  • Готовое и отлаженное API.

В статье расскажу, как мы создали «Адрес по координатам»: наладили поиск, собрали справочник и упаковали в готовый метод.
Читать полностью »

Недавно мне на глаза попался датасет на Kaggle с данными о 45 тысячах фильмов с Full MovieLens Dataset. Данные содержали не только информацию об актерах, съемочной команде, сюжете и т.п., но и оценки, выставленные фильмам пользователями ресурса (26 миллионов оценок от 270 тыс.пользователей).

Стандартная задача для таких данных — это рекомендательная система. Но мне в голову почему-то пришло прогнозирование рейтинга фильма на основе информации, доступной до его выхода. Я не знаток кинематографа, и поэтому обычно ориентируюсь на рецензии, выбирая что посмотреть из новинок. Но ведь рецензенты тоже несколько biased — они-то смотрят гораздо больше разных фильмов, чем рядовой зритель. Поэтому спрогнозировать, как оценит фильм обычная публика, показалось занятным. Читать полностью »

Серия «Белый шум рисует черный квадрат»

История цикла этих публикаций начинается с того, что в книге Г.Секей «Парадоксы в теории вероятностей и математической статистике» (стр.43), было обнаружено следующее утверждение:

Треугольник Паскаля vs цепочек типа «000…-111…» в бинарных рядах и нейронных сетях - 1
Рис. 1.

По анализу комментарий к первым публикациям (часть 1, часть 2) и последующими рассуждениями созрела идея представить эту теорему в более наглядном виде.

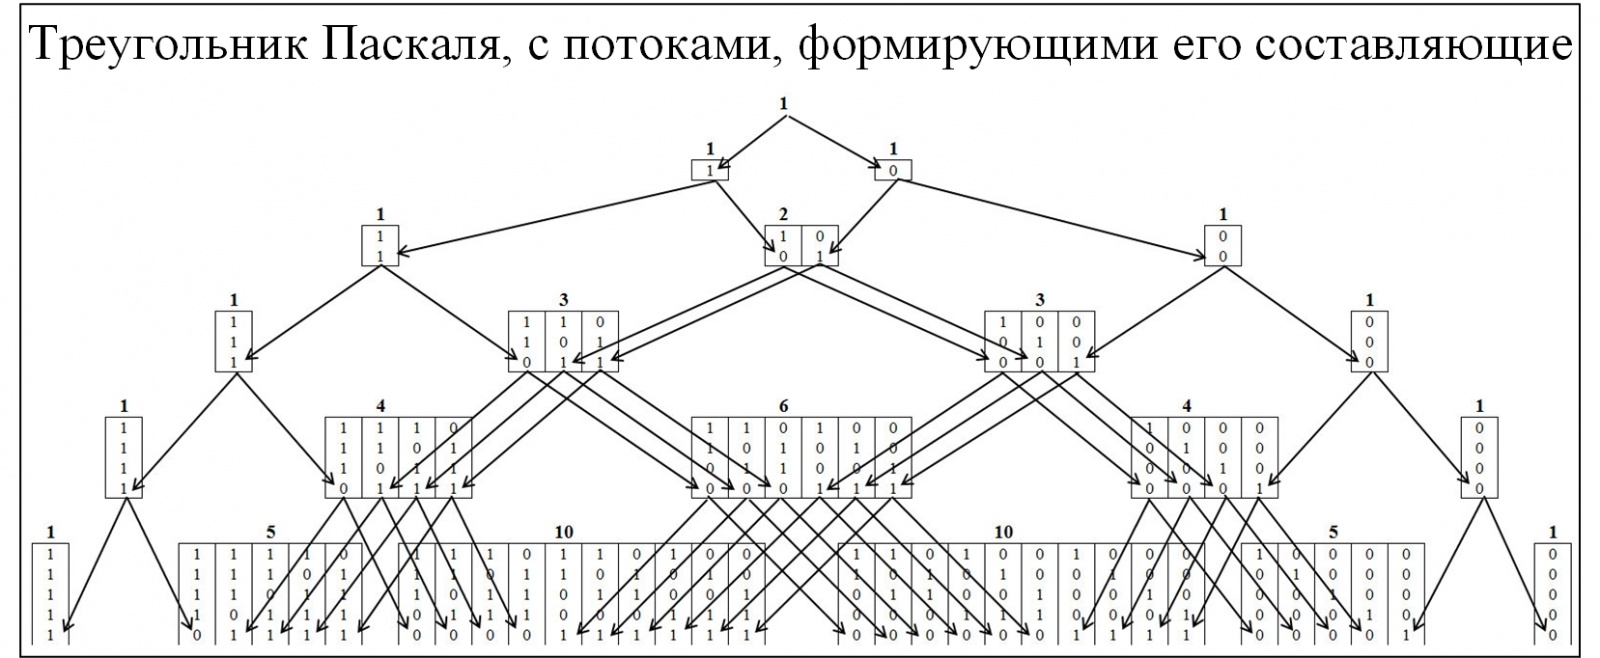
Большинству из участников сообщества знаком треугольник Паскаля, как следствие биноминального распределения вероятностей и многие сопутствующие законы. Для понимания механизма образования треугольника Паскаля развернем его детальнее, с развертыванием потоков его образования. В треугольнике Паскаля узлы формируются по соотношению 0 и 1, рисунок ниже.

Треугольник Паскаля vs цепочек типа «000…-111…» в бинарных рядах и нейронных сетях - 2
Рис. 2.

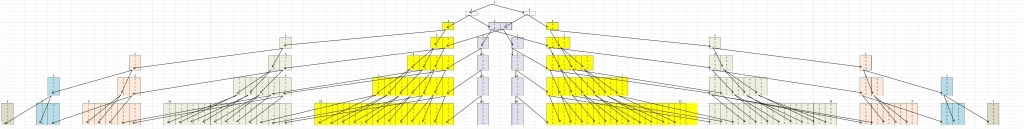
Для понимания теоремы Эрдёша-Реньи составим аналогичную модель, но узлы будут формироваться из значений, в которых присутствуют наибольшие цепочки, состоящие последовательно из одинаковых значений. Кластеризации будет проводиться по следующему правилу: цепочки 01/10, к кластеру «1»; цепочки 00/11, к кластеру «2»; цепочки 000/111, к кластеру «3» и т.д. При этом разобьём пирамиду на две симметричные составляющие рисунок 3.

Треугольник Паскаля vs цепочек типа «000…-111…» в бинарных рядах и нейронных сетях - 3
Рис. 3.

Первое что бросается в глаза это то, что все перемещения происходят из более низкого кластера в более высокий и наоборот быть не может. Это естественно, так как если цепочка размера j сложилась, то она уже не может исчезнуть.
Читать полностью »

Вице-президент РАН Алексей Хохлов попытался выяснить у министра здравоохранения Вероники Скворцовой, где на сайте Минздрава публикуются заключения «экспертизы качества лекарственного средства». Лишь после подтверждения качества препараты допускаются в оборот, сообщилиЧитать полностью »

Waymo открыла доступ к большому датасету для обучения беспилотных автомобилей - 1

Компания Waymo открыла в общий доступ и только для некоммерческого использования большой датасет, предназначенный для обучения алгоритмов беспилотных автомобилей.

Датасет «Waymo Open Dataset» содержит в себе тысячу двадцатисекундных записей, собранных с пяти лидаров и пяти камер во время реальных поездок по четырем американским городам с разными дорожными и погодными условиями, как пояснено в блоге компании.

Большая часть данных в датасете маркирована и содержит в себе суммарно о 12 млн. 3D меток и 1,2 млн. 2D меток различных объектов вокруг автомобиля.
Читать полностью »

В первой публикации рассказывалось о том, что есть подзабытая теорема Эрдёша-Реньи, из которой следует, что в случайном ряде, длины N, с вероятностью близкой к 1 существует подряд из одинаковых значений длиной log_2{N}. Указанное свойство случайной величины можно использовать для ответа на вопрос: «После обработки больших данных, подчиняется ли остаточный ряд закону случайных чисел или нет?»

Ответ на такой вопрос определялся не на основании тестов соответствия нормальности распределения, а на основании свойств самого остаточного ряда.
Читать полностью »

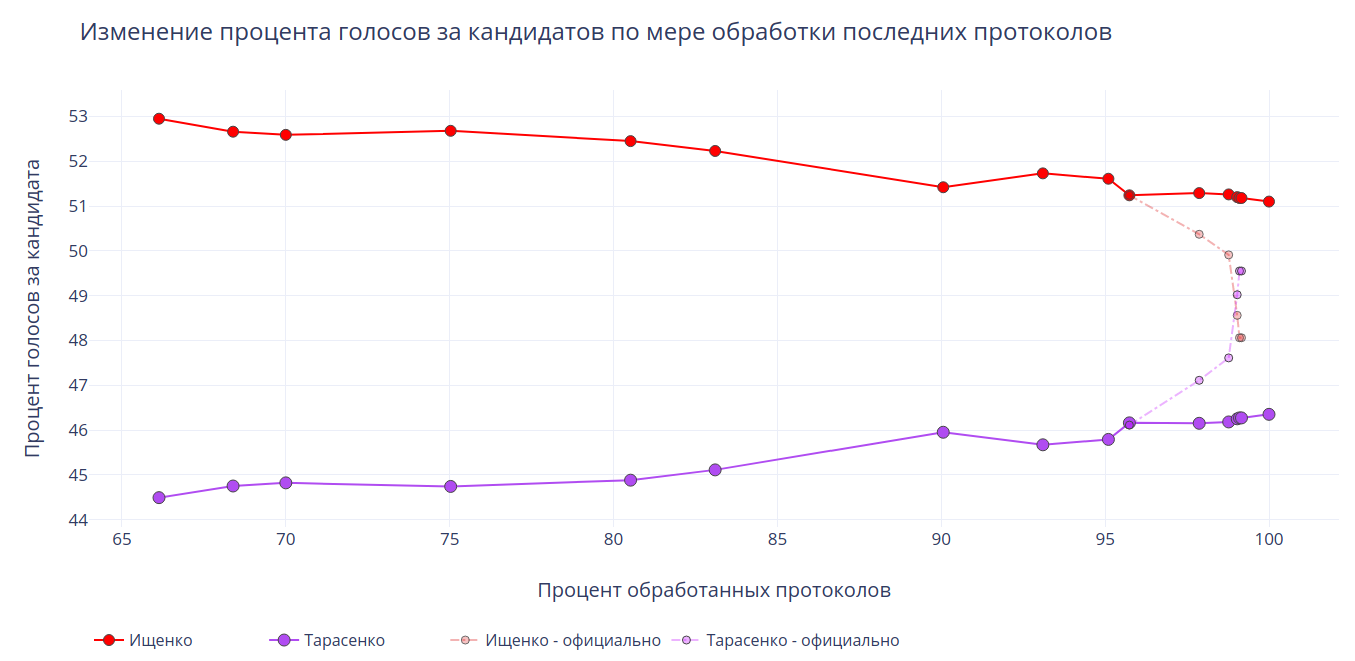
Во втором туре выборов губернатора Приморского края 16 сентября 2018 года встречались действующий и.о. губернатора Андрей Тарасенко и занявший второе место в первом туре коммунист Андрей Ищенко. В ходе подсчета голосов на сайте ЦИК РФ отображалась информационная панель с растущим числом обработанных протоколов и голосов за кандидатов.

Публикация подробных данных по участкам на официальном сайте ЦИК www.izbirkom.ru замерла после ввода 1484 (95.74%) протоколов и не возобновлялась до самого конца. Поэтому когда в трансляции лидер голосования вдруг поменялся с Ищенко на Тарасенко, было неясно, как именно это могло произойти. В СМИ просто писали «после обработки 99,03% протоколов лидер сменился».

Однако, располагая промежуточными суммарными данными из информационной панели, с помощью простой математики и программирования можно подробно установить, что именно происходило с протоколами в ночь после выборов. Используем Python, Colab от Google и Z3 theorem prover от Microsoft Research. Ну и добьём всё обычной дедукцией.

Математическое расследование, как подделывали выборы губернатора в Приморье 16 сентября 2018 года - 1
Читать полностью »

Любой аналитик, в начале своей работы, проходит ненавистный этап определения идентификации параметров распределения. Потом, с наработкой опыта, для него согласование полученных остаточных разбросов означает, что какой-то этап, в анализе Big Data, пройден и можно двигаться дальше. Уже нет необходимости проверять сотни моделей на соответствие различным уравнениям регрессии, искать отрезки с переходными процессами, составлять композицию моделей. Терзать себя сомнениями: «Может есть, еще какая-нибудь модель, которая больше подходит?»
Подумал: «А что, если пойти от противного. Посмотреть, что может сделать белый шум. Может ли белый шум создать, что-то, что наше внимание сопоставит со значимым объектом из нашего опыта?»
Белый шум рисует черный квадрат - 1
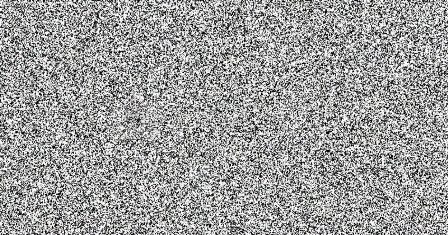
Рис. Белый шум (файл взят из сети, размер 448х235).

По этому вопросу рассуждал так:
1. Какова вероятность, что появится горизонтальные и вертикальные линии, заметной длины?
2. Если они могут появиться, то какова вероятность, что они совпадут своим началом по одной из координат и составят прямоугольную фигуру?
Дальше по тексту, объясню, как эти задачи связались с анализом Big Data.
Читать полностью »

Толока — крупнейший источник размеченных людьми данных для задач машинного обучения. Каждый день в Толоке десятки тысяч исполнителей производят более 5 миллионов оценок. Для любых исследований и экспериментов, связанных с машинным обучением, необходимы большие объёмы качественных данных. Поэтому мы начинаем публиковать открытые датасеты для академических исследований в разных предметных областях.

Сегодня мы поделимся ссылками на первые публичные датасеты и расскажем о том, как они собирались. А ещё подскажем, где же правильно ставить ударение в названии нашей платформы.

Читать полностью »


https://ajax.googleapis.com/ajax/libs/jquery/3.4.1/jquery.min.js