Синтетические тесты в вакууме не показывают реальной пользы нейросетей. Индустрии пора переходить на метрики, где во главе угла стоят люди и жизненный контекст
От переводчика:Читать полностью »
Синтетические тесты в вакууме не показывают реальной пользы нейросетей. Индустрии пора переходить на метрики, где во главе угла стоят люди и жизненный контекст
От переводчика:Читать полностью »
При использовании ИИ-инструментов для написания кода неизбежно возникает вопрос: а какая модель лучше? Часто синтетические бенчмарки не отражают реальной картины, модели при их обучении могут специально натаскиваться на прохождение этих бенчмарков. А между решением изолированных задач и работой с реальной кодовой базой есть существенная разница. Модель должна понять требования, разобраться в архитектуре проекта, корректно встроить новую функциональность и ничего не сломать.

В середине 2024 года GPT-4 спотыкался на школьных задачах, а к концу 2025-го модели щёлкали олимпиадные как орехи. Полтора года, и мы преодалели дистанцию от «найди икс» до «докажи теорему». Epoch AI решили заглянуть еще дальшеЧитать полностью »
Всем привет! Это моя первая статья на Хабре, так что буду рад любым комментариям. Я бы хотел затронуть одну из самых сложных и больных тем в IT и электронике, из-за которой создают сотни бенчмарков и тестов, но вопрос всё равно остается открытым: как сравнить 2 процессора? Какую архитектуру выбрать в конкретной задаче, когда у тебя ограниченный бюджет и условия?
Вчера вышла новая версия модели ChatGPT 5.2. В очередной раз Сэм Альтман и OpenAI удивляют качеством модели (в последний месяц было так много релизов, что они решили не отставать). В целом, все как обычно — топовые результаты на большинстве бенчмарков.
Но хочу уделить внимание одному очень сложному бенчмарку, на котором пока многие спотыкаются — ARC-AGI (Abstract and Reasoning Corpus for Artificial General Intelligence). Именно здесь ChatGPT 5.2 показал значительный скачок.
На сегодня существует две версии этого теста. Так о чем же он?
История начинается в 2019 году со статьиЧитать полностью »
Провели РКИ на реальных задачах в крупных OSS-репозиториях: 16 опытных контрибьюторов, 246 задач (исправления, фичи, рефакторинг), на каждую задачу случайно разрешали/запрещали ИИ.
Инструменты при «разрешено»: в основном Cursor Pro + Claude 3.5/3.7; при «запрещено» — обычная работа без генеративного ИИ.
Главный итог: с ИИ задачи выполнялись в среднем на 19% дольше; качество PR сопоставимо между условиями.
Перцепция расходится с данными: разработчики ожидали ускорение (~24%) и постфактум тоже считали, что ускорились (~20%).
Продолжаю адаптированный перевод статьи китайских исследователей Retrieval-Augmented Generation for Large Language Models: A Survey (ссылка на первую часть — здесь, на вторую часть — здесь, третью часть — здесь, четвёртую часть — здесь). Перевод этой части мы выполняли в тандеме с коллегой — Мариной Хазиевой. К некоторым терминам, как и в прошлых частях, добавлены переводы и пояснения для удобства начинающих ИТ-переводчиков.
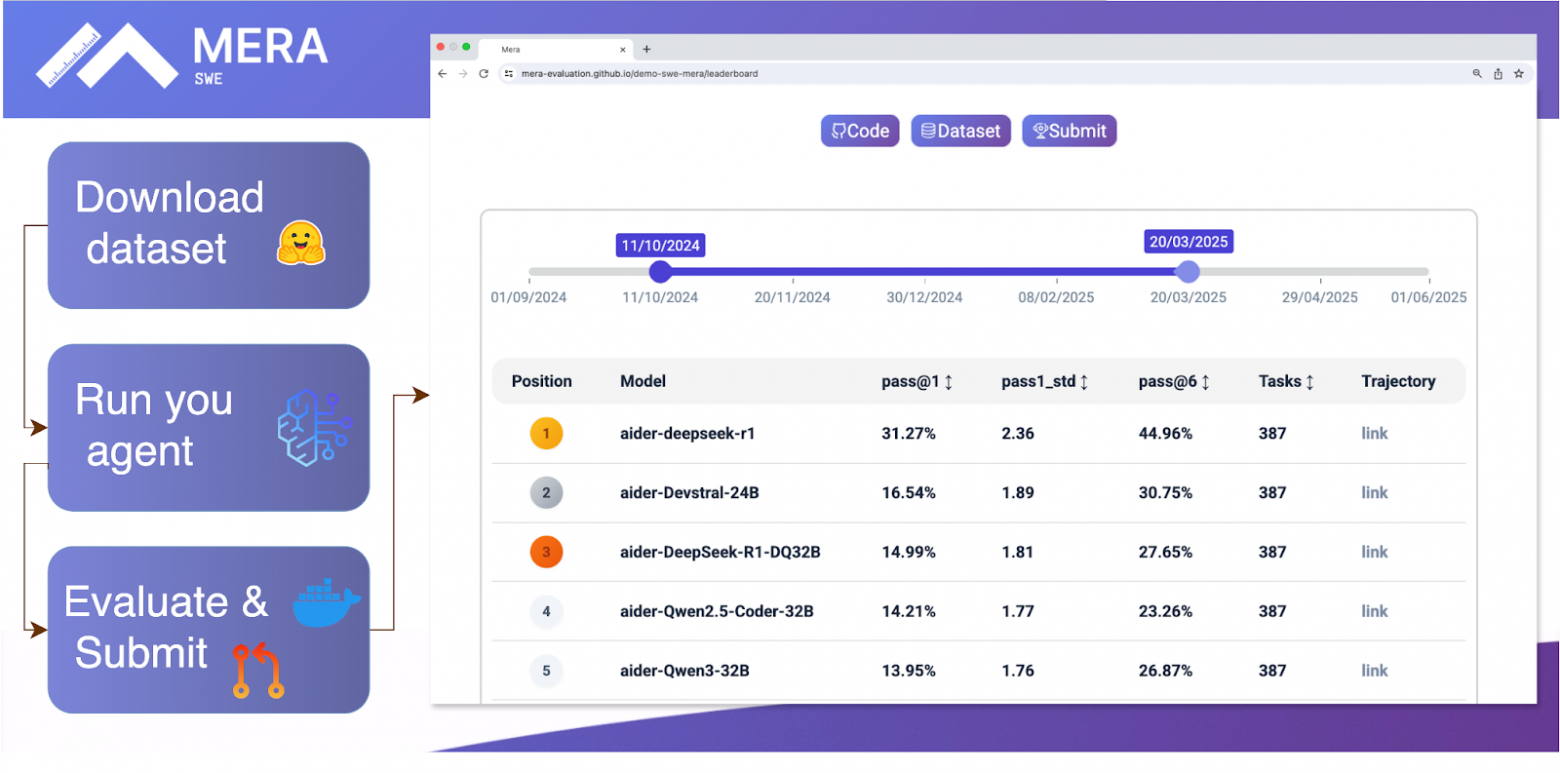
Всем привет! Пару месяцев назад Альянс в сфере искусственного интеллекта, в который MWS AI тоже входит, запустилЧитать полностью »
Когда речь заходит о гиперпоточности, то как правило всё начинается с того, что нам показывают красивые картинки с квадратиками типа такой: