Рубрика «data science» - 18

Всем привет. С некоторым запозданием я решил опубликовать эту статью. Каждый год я стараюсь подвести итоги произошедшего в области обработки естественного языка (natural language processing). Не стал исключением и этот год.

BERTs, BERTs are everywhere

Начнем по порядку. Если вы не уехали в глухую Сибирскую тайгу или отпуск на Гоа на последние полтора года, то вы наверняка слышали слово BERT. Появившись в самом конце 2018-ого за прошедшее время эта модель завоевала такую популярность, что в самый раз будет вот такая картинка:

Natural Language Processing. Итоги 2019 и тренды на 2020 - 1
Читать полностью »

Дмитрий Казаков, Data Analytics Team Lead в Kolesa Group, делится инсайтами из первого казахстанского опроса специалистов по работе с данными.
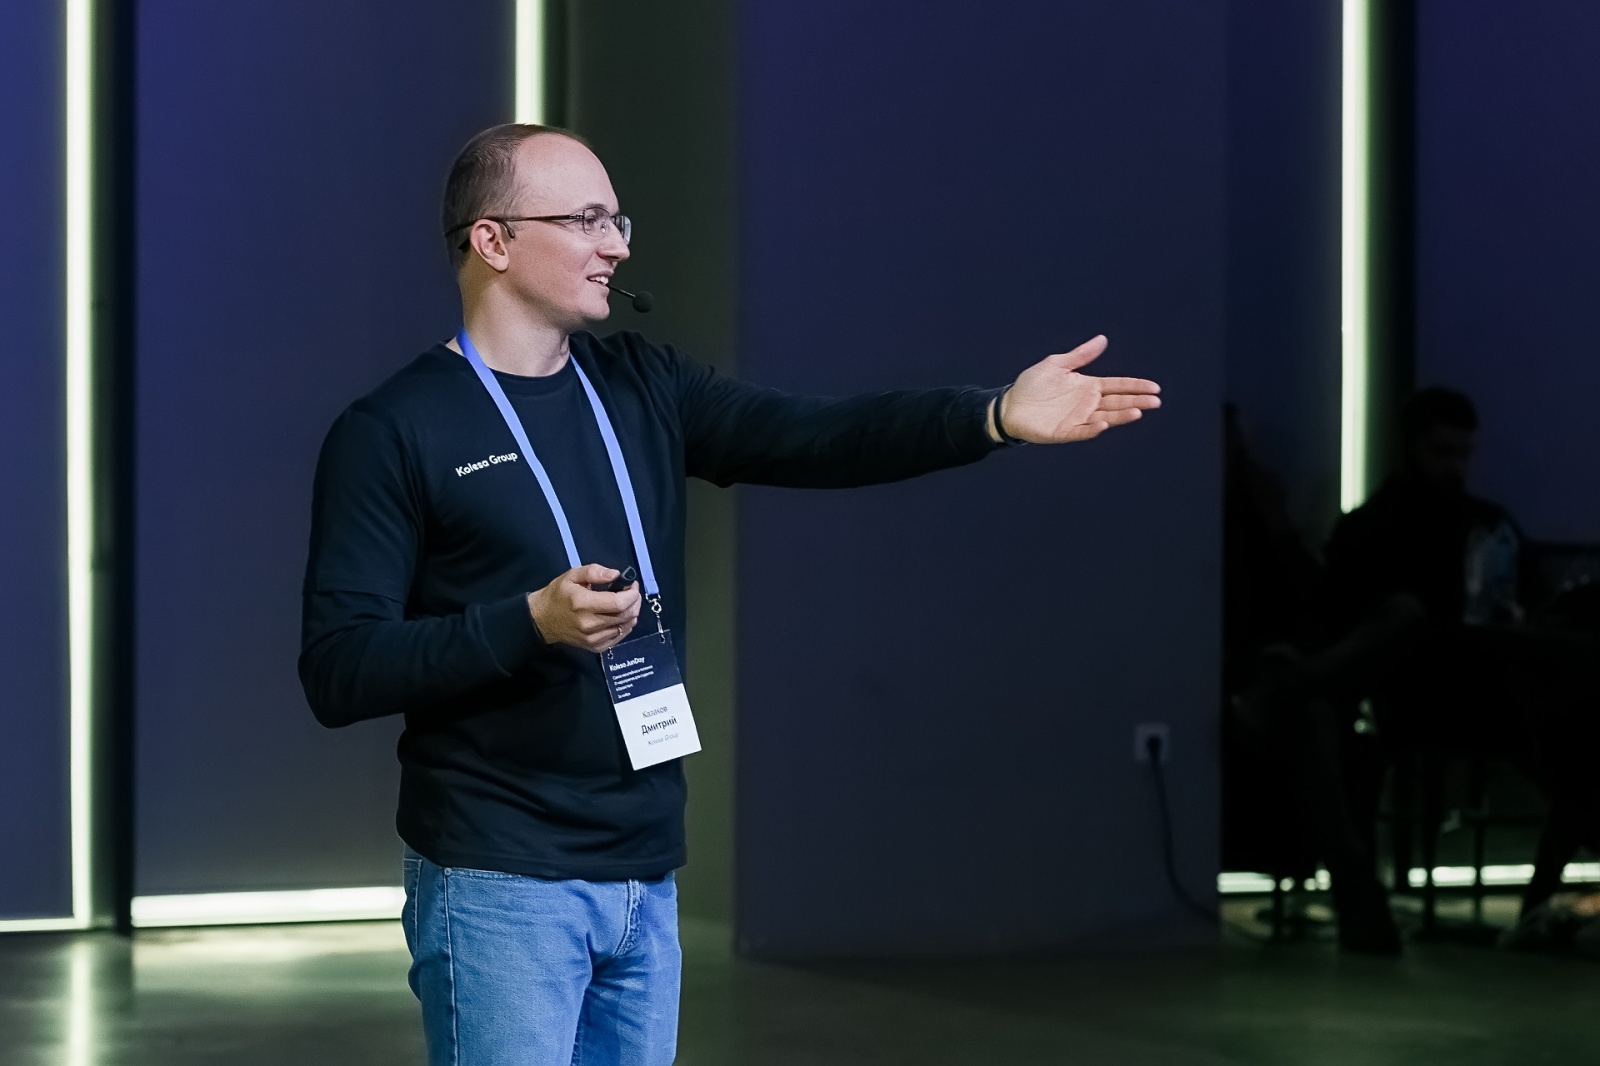
«Да, они существуют!» Чем занимаются и сколько зарабатывают Data Science-специалисты в Казахстане? - 1
На фото: Дмитрий Казаков

Помните популярную фразу о том, что Big Data больше всего напоминает подростковый секс – все о нем говорят, но никто не знает, есть ли он на самом деле. То же самое можно было сказать и о рынке специалистов по работе с данными (в Казахстане) – хайп есть, а кто за ним стоит (и есть ли там вообще хоть кто-то), не было до конца понятно – ни эйчарам, ни менеджерам, ни самим дата-сайентистам.

Мы провели исследование, в рамках которого опросили более 300 специалистов об их зарплатах, функциях, скиллах, инструментах и много еще о чем.

Спойлер: да, они точно существуют, но все не так однозначно.

Приятный инсайт. Во-первых, специалистов по работе с данными больше чем мы ожидали. Нам удалось опросить 300 человек, среди которых есть не только product-, marketing- и BI-аналитики, но и ML-, DWH-инженеры, что особенно порадовало. В самой большой группе оказались все те, кто называет себя дата-сайентистами – это 36% опрошенных. Покрывает это запрос рынка или нет, сказать сложно, потому что сам рынок только формируется. Читать полностью »

Статья является кратким обзором о сертификации по программе IBM Data Science Professional Certificate.

Будучи новичком в Python, мне пришлось столкнуться с реализацией задач:

  • Загрузка и парсинг HTML таблиц
  • Очистка загруженных данных
  • Поиск географических координат по адресу объекта
  • Загрузка и обработка GEOJSON
  • Построение интерактивных тепловых карт (heat map)
  • Построение интерактивных фоновых картограмм (choropleth map)
  • Преобразование географических координат между сферической WGS84 и картезианский системой координат UTM
  • Представление пространственных географических объектов в виде гексагональная сетки окружностей
  • Поиск географических объектов, расположенных на определенном расстоянии от точки
  • Привязка географических объектов к полигонам сложной формы на поверхности
  • Описательные статистический анализ
  • Анализ категорийных переменных и визуализация результатов
  • Корреляционный анализ и визуализация результатов
  • Сегментация с использованием k-Mean кластеризации и elbow метода
  • Анализ и визуализация кластеров

Читать полностью »

Туториал по Uplift моделированию. Часть 2 - 1

В первой части мы познакомились с uplift моделированием и узнали, что метод позволяет выбирать оптимальную стратегию коммуникации с клиентом, а также разобрали особенности сбора данных для обучения модели и несколько базовых алгоритмов. Однако эти подходы не позволяли оптимизировать uplift напрямую. Поэтому в этой части разберем более сложные, но не менее интересные подходы.
Читать полностью »

Предыдущий выпуск

Экзоскелеты; бионические протезы; промышленные роботы; исследование автоматических рекоммендаций Ютуба; создание моделей машинного обучения в браузере с помощью MediaPipe; виртуальная клавиатура для смартфонов; 5G; еще раз о сильном и слабом ИИ.

Читать полностью »

Туториал по uplift моделированию. Часть 1 - 1


Команда Big Data МТС активно извлекает знания из имеющихся данных и решает большое количество задач для бизнеса. Один из типов задач машинного обучения, с которыми мы сталкиваемся – это задачи моделирования uplift. С помощью этого подхода оценивается эффект от коммуникации с клиентами и выбирается группа, которая наиболее подвержена влиянию.

Такой класс задач прост в реализации, но не получил большого распространения в литературе про машинное обучение. Небольшой цикл статей, подготовленный Ириной Елисовой (iraelisova) и Максимом Шевченко (maks-sh), можно рассматривать как руководство к решению таких задач. В рамках него мы познакомимся с uplift моделями, рассмотрим, чем они отличаются от других подходов, и разберем их реализации.
Читать полностью »

image

Этим летом библиотека OpenCV отмечает свой двадцатый юбилей. OpenCV — самая большая библиотека компьютерного зрения в мире. Она используется чуть ли не в каждом мобильном телефоне, планшете и камере, не говоря уже о настольных системах и серверах. SourceForge рапортует о 20 миллионах скачиваний релизных версий библиотеки, и это число продолжает расти.
Читать полностью »

Рубрика «Читаем статьи за вас». Октябрь — Декабрь 2019 - 1

Привет! Продолжаем публиковать рецензии на научные статьи от членов сообщества Open Data Science из канала #article_essense. Хотите получать их раньше всех — вступайте в сообщество!

Статьи на сегодня:

  1. Poly-encoders: Transformer Architectures and Pre-training Strategies for Fast and Accurate Multi-sentence Scoring (Facebook, 2019)
  2. Implicit Discriminator in Variational Autoencoder (Indian Institute of Technology Ropar, 2019)
  3. Self-training with Noisy Student improves ImageNet classification (Google Research, Carnegie Mellon University, 2019)
  4. Momentum Contrast for Unsupervised Visual Representation Learning (Facebook, 2019)
  5. Benchmarking Neural Network Robustness to Common Corruptions and Perturbations (University of California, Oregon State University, 2019)
  6. DistilBERT, a distilled version of BERT: smaller, faster, cheaper and lighter (Hugging Face, 2019)
  7. Plug and Play Language Models: A Simple Approach To Controlled Text Generation (Uber AI, Caltech, HKUST, 2019)
  8. Deep Salience Representation for F0 Estimation in Polyphonic Music ( New York University, USA, 2017)
  9. Analyzing and Improving the Image Quality of StyleGAN (NVIDIA, 2019)

Читать полностью »

Предыдущий выпуск

Новости ML, новые технологии, идеи по применению и гипотезы.

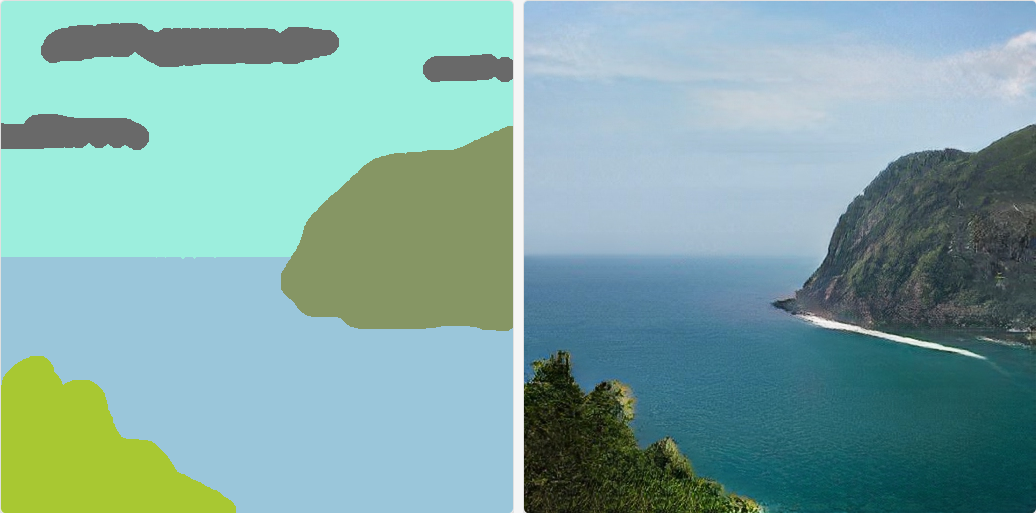
Nvidia GauGan

Изображение сделано в Nvidia GauGan. Видео, статья и исходный код.

Читать полностью »

Скандал на конкурсе Kaggle: победитель сжульничал, алгоритм плохо оценивает шанс бездомных животных найти хозяев - 1

Kaggle — система организации конкурсов по исследованию данных, принадлежащая компании Google — обнаружила мошенничество в результатах одного из своих конкурсов. Победителя конкурса отстранили от участия в дальнейших соревнованиях.

Kaggle регулярно организует конкурсы в сфере обработки данных и машинного обучения. Призы на этих конкурсах могут достигать десятков тысяч долларов. На прошлой неделе компания объявила, что команда-победитель конкурса, который состоялся в прошлом году и был посвящён улучшению работы сайта по поиску хозяев для бездомных животных, выиграла обманом. Читать полностью »


https://ajax.googleapis.com/ajax/libs/jquery/3.4.1/jquery.min.js