
В 2012 году на Хабре уже была моя статья про быстрое сжатие в JPEG на видеокарте. С тех пор прошло уже довольно много времени и мне хотелось бы в общих чертах рассказать про результаты, которые были получены по этой теме. Надеюсь, многим будет интересно узнать, какой уровень производительности можно получить на современных видеокартах NVIDIA при решении практических задач на CUDA.
Читать полностью »
Рубрика «параллельное программирование» - 22
Ещё раз про быстрый JPEG на CUDA
2016-06-15 в 15:52, admin, рубрики: 12-bit JPEG, CUDA JPEG Codec, fast lossy compression, gpgpu, GPU JPEG benchmark, HPC, JPEG encoder and decoder on GPU, JPEG performance, NVIDIA GeForce 1080, быстрое сжатие изображений, высокая производительность, кодек джипег, обработка изображений, параллельное программирование, параллельные вычисления, сжатие данных, метки: CUDA JPEG Codec, GPU JPEG benchmark, JPEG encoder and decoder on GPU, NVIDIA GeForce 1080Немного о Stream API(Java 8)
2016-06-06 в 8:42, admin, рубрики: java, stream api, ооп, параллельное программированиеНебольшая статья с примерами использования Stream API в Java8, которая, надеюсь, поможет начинающим пользователям освоить и использовать функционал.

Событийная модель на основе async и await
2016-06-03 в 10:04, admin, рубрики: .net, async, C#, параллельное программированиеВ далеком 2012, когда цена на нефть еще была трехзначной, а трава зеленее, майкрософтом был выпущен .NET 4.5, а с ним и конструкция async/await. Про неё написано уже довольно много статей (Async в C#), а большинство разработчиков C# хорошо её изучили. Но все ли варианты использования были рассмотрены, можно ли выжать из await немного больше?
Самым очевидным вариантом использованием этой конструкции является ожидание завершения некой асинхронной операции. Первое, что приходит на ум — это ожидание ввода-вывода. Например, мы послали запрос клиенту и ожидаем ответа, тогда используя await мы сможем продолжить выполнение кода после получения ответа, а сам код при этом будет выглядеть синхронным. Но что если во время ожидания возникнет необходимость прервать выполнение этой операции? Тогда нам придется использовать CancellationToken, причем если таких операций несколько, то токены необходимо будет линковать или использовать один общий токен. При этом причина отмены будет скрыта от кода, использующего этот CancellationToken. Кроме отмены, код должен поддерживать обработку потери соединения, таймаута, возвращаемых ошибок и т.д.
В классическом варианте это выльется в использование CancellationToken для обработки отмены, try catch для обработки разрыва соединения и код анализа возвращенных данных, для оценки результата запроса. Но можно ли уместить всё это в единой парадигме? В этот статье я предлагаю рассмотреть альтернативный подход, основанный на событийной модели с использованием синтаксического сахара async/await.
Читать полностью »
Статистика распределения доменов по AS, IP, NS, MX и прочим параметрам
2016-05-27 в 12:53, admin, рубрики: BigData, firststat.ru, mysql, open source, python, statistics, Занимательные задачки, параллельное программированиеДавным-давно перестал работать 1stat.ru — откровенно говоря, для нас это была трагедия (сейчас вроде он как-то работает).
Рабочий день обычно начинался с чашечки кофе и приятного просмотра значений прироста доменов. Конечно же, такие метрики не показывают ни успешность компании, ни ее капитализацию, ни тип клиентов, которые размещаются у компании. Но, несмотря на это, косвенно можно оценить динамику роста или деградации компании — если количество доменов на NS серверах растет, а не падает — это хорошо. Как показала практика, это, так или иначе, отражает положение дел на рынке.
Разве Tesseract распознаёт медленно?
2016-05-17 в 9:27, admin, рубрики: ocr, open source, tesseract, Алгоритмы, Блог компании Smart Engines Ltd., оптимизация, параллельное программирование, Программирование, профилирование, распознавание текста, распознавание цифр
Работу каждой программы можно ускорить минимум в десять раз
Рабочая установка разработчиков Smart Engines
Мы расскажем о нескольких приемах ускорения распознавания с помощью OCR Tesseract. Всё рассказанное было использовано в реализации проекта, смысл которого состоял в классификации большого числа образов страниц деловых документов (таких документов как паспорт, договор, контракт, доверенность, свидетельство о регистрации и т.п.) и сохранении результатов в электронном архиве. Часть алгоритмов классификации была основана на анализе собственно образов страниц, а часть – на анализе извлечённых из образа текстов. Для извлечения текстов было необходимо распознавание с помощью OCR.
Многопоточные вычисления в PHP: pthreads
2016-05-17 в 6:22, admin, рубрики: php, pthreads, параллельное программирование, ПрограммированиеНедавно я попробовал pthreads и был приятно удивлен — это расширение, которое добавляет в PHP возможность работать с несколькими самыми настоящими потоками. Никакой эмуляции, никакой магии, никаких фейков — все по-настоящему.

Я рассматриваю такую задачу. Есть пул заданий, которые надо побыстрее выполнить. В PHP есть и другие инструменты для решения этой задачи, тут они не упоминаются, статья именно про pthreads.
Стоит отметить, что автор расширения, Joe Watkins, в своих статьях предупреждает, что многопоточность — это всегда не просто и надо быть к этому готовым.
Кто не испугался, идем далее.
Игра «Жизнь» в FPGA
2016-04-28 в 19:40, admin, рубрики: fpga, hdmi, игра жизнь, Марсоход3, ненормальное программирование, Параллелизм, параллельное программирование, ПЛИС, метки: Игра жизнь, параллелизмИгру жизнь — клеточный автомат уже кажется писали на всех возможных языках программирования.
Меня же интересует технология ПЛИС — и поэтому когда-то я сделал реализацию life для ПЛИС Альтера Cyclone III. Правда поместилось в чип тогда очень мало: всего 32x16 клеток. На таком маленьком поле довольно трудно испытать сложные фигуры.
Сейчас у меня в руках другая плата: тут уже стоит Altera MAX10 с 50-ю тысячами логических элементов. Было интересно, смогу ли я расширить поле хотя бы в 4 раза? В общем задумал сделать хотя бы 64x32.
Результат представлен на этом видео, я называю эту картину: «ружье Госпера убивает самоё себя».
Ниже подробности реализации.Читать полностью »
Новый курс по микроконтроллерам — совместный проект индустрии и университетов
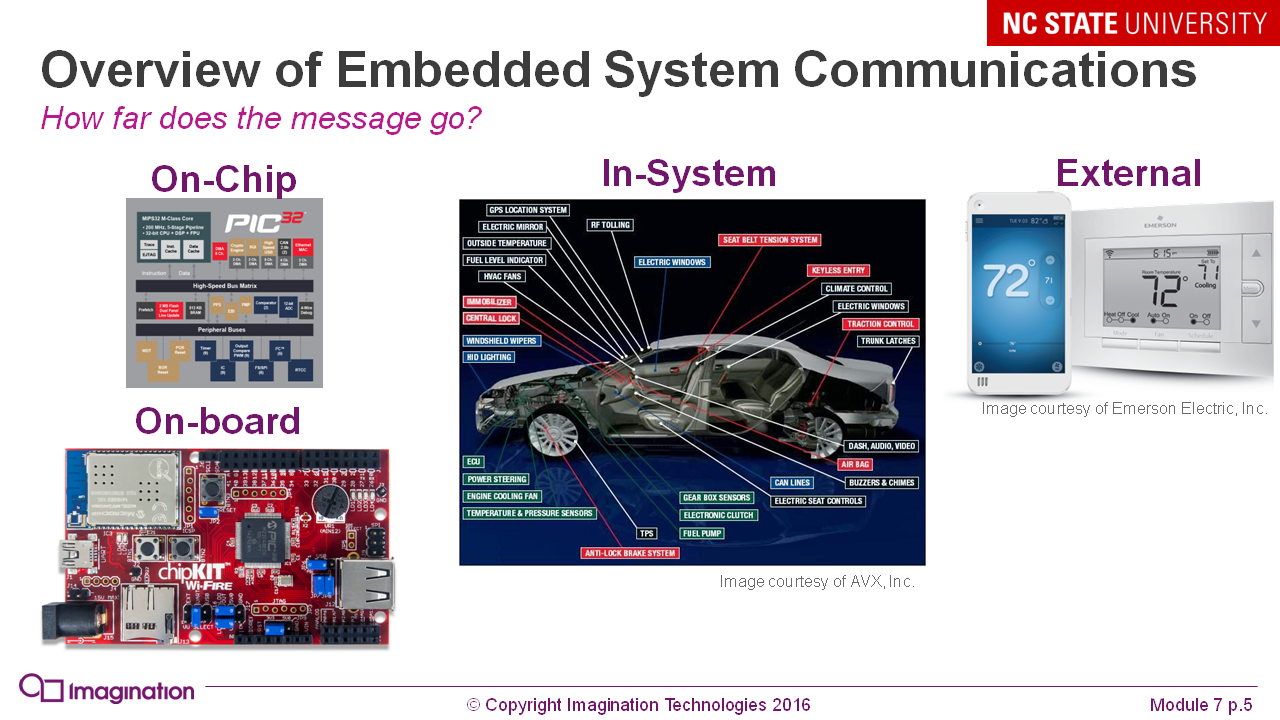
2016-04-20 в 6:06, admin, рубрики: assembly, cloud computing, digilent, imagination technologies, Microchip Technology, mips, MIPS microAptiv UP, national instruments, PIC32MZ, rtos, интерфейсы, Облачные вычисления, параллельное программирование, программирование микроконтроллеровБританская компания, две американские компании и 18 университетов (включая российские МИЭТ, ИТМО, СГАУ, ННТУ) сотрудничали, чтобы выпустить современный курс по микроконтроллерам c небольшой привязкой к интернету вещей. Об этом – сегодняшний пресс-релиз Imagination Technologies, Microchip Technology и Digilent (отделения National Instruments). Главный автор — профессор Александр Дин из университета Северной Каролины. В отличие от более легковестных курсов интернета вещей, новый курс подводит под предмет твердую инженерную базу – в нем подробно обсуждается использование RTOS-ов, архитектура микропроцессорного ядра микроконтроллера, протоколы периферии и даже оптимизация алгоритмов при программировании.
Скачать курс можно здесь:
https://community.imgtec.com/university/resources/connected-microcontroller-lab/
В пресс-релизе, помимо цитат из США, Великобритании, Германии, Китая, есть и цитата из России:
– Alexey Pereverzev, Head of Computer Engineering, National Research University of Electronic Technology (MIET), Russia
Пару десятков слайдов из курса, чтобы вы почувствовали его вкус:
Разбавляем асинхронное программирование функциональным на Scala
2016-04-11 в 10:38, admin, рубрики: asynchronous, functional programming, scala, scalaz, tutorial, параллельное программирование, функциональное программированиеПриветствую! В этой статье будет показано, как, имея на руках обычные Future-ы, сделать в scala подобие корутин и асинхронные stream-ы. Этакий небольшой туториал по функциональному программированию.
Что это и зачем
Что такое Future человеческим языком
Future — это сущность, описывающая результат некоторых вычислений, который мы получим не сразу, но в будущем. Но есть одна особенность: зачастую мы, не зная еще результата, точно знаем, что мы с ним будем делать. Например, мы попросили у сервера какой-то конфиг, и теперь у нас есть Future[Config]. Сам конфиг мы еще не получили, но точно знаем, что, когда получим, то достанем из него адрес и по этому адресу попросим у сервера картинку (config => Future[Image]). И Future[Config] способна изменяться таким образом, чтобы мы вместо конфига и потом картинки могли получить сразу картинку. Сущности, способные комбинироваться таким способом, называются монадами.
К сожалению, простое последовательное комбинирование 2х и более асинхронных операций (загрузить конфиг, а потом картинку по адресу из конфига как пример) — это все, на что способны обычные Future-ы в качестве монад. Они не позволяют ни сохранять состояние, ни делать циклы из асинхронных операций, ни выдавать несколько (или бесконечно много) значений. Вот этими недостатками мы сейчас и займемся.
Давайте для определенности представим некий виджет. Он ждет конфиг, который обновляется с определенной периодичностью, загружает по адресу из конфига значение (например, температуру), и рисует на экране текущее значение, минимум, максимум, среднее и так далее. И все это делает в цикле, да еще и асинхронно.
Применив знания из этой статьи, мы сможем этот процесс описать примерно так:
Код
// Про 'FState' - далее, пока же просто примем, что это - такая необычная Future
def getNextConfig: FState[Config]
def getTemperature(from: String): FState[Int]

case class State(temperature: Int, sumTemp: Long, count: Int) {
  def isGood = ...
}

// Как видим, получается единый асинхронный алгоритм с состоянием,
// которое извне этого алгоритма не видно
val handle =
  while_ ( _.isGood)
  {  for (
        config <- getNextConfig();
        if (config.isDefined);  // пустой конфиг - прекращаем выполнение
        nextValue <- getTemperature(config().source);  // грузим значение температуры
        state <- gets[State];  // тут мы берем текущее состояние
        newState = State(nextValue, state.sumTemp + nextValue, state.count + 1);
        _ <- puts(newState);  // .. и меняем его
        _ <- runInUiThread { drawOnScreen(newState) }
  ) yield() }
Или вот так:
Код
val configs: AsyncStream[Config] = ... // получаем откуда-то stream конфигов

def getTemperature(from: String): FState[Int]

case class State(temperature: Int, sumTemp: Long, count: Int)

// Получается то же самое, только вместо зависимости 'getNextConfig'
// мы, по сути, передаем сами данные - stream из конфигов
val handle =
  foreach(configs) {
    config => for (
        nextValue <- getTemperature(config().source);  // грузим значение температуры
        state <- gets[State];  // тут мы берем текущее состояние
        newState = State(nextValue, state.sumTemp + nextValue, state.count + 1);
        _ <- puts(newState);  // .. и меняем его
        _ <- runInUiThread { drawOnScreen(newState) }
    ) yield()
  }
Всех, кто заинтересовался, прошу под кат.
Читать полностью »
Конкурс GraphHPC-2016 на самую быструю реализацию параллельного алгоритма Community Detection: Итоги
2016-04-04 в 11:47, admin, рубрики: community detection, gpgpu, graph processing, HPC, parallel programming, Алгоритмы, высокая производительность, параллельное программирование, Спортивное программирование 
В рамках конференции GraphHPC-2016, прошедшей 3 марта 2016 года в МГУ им. М.В. Ломоносова на факультете ВМК, проводился конкурс на самую быструю реализацию задачи Community Detection — поиска сообществ в неориентированном графе с весами.Читать полностью »