Рубрика «распределенные системы» - 19

Я присоединился к Uber два года назад в качестве мобильного разработчика, имеющего некоторый опыт разработки бекенда. Здесь я занимался разработкой функционала платежей в приложении — и по ходу дела переписал само приложение. После чего я перешёл в менеджмент разработчиков и возглавил саму команду. Благодаря этому я смог гораздо ближе познакомиться с бэкендом, поскольку моя команда несёт ответственность за многие системы нашего бэкенда, позволяющие осуществлять платежи.

До моей работы в Uber у меня не было опыта работы с распределёнными системами. Я получил традиционное образование в Computer Science, после чего с десяток лет занимался full-stack разработкой. Поэтому, пусть я и мог рисовать различные диаграммы и рассуждать о компромиссах (tradeoffs) в системах, к тому моменту я недостаточно хорошо понимал и воспринимал концепции распределённости — такие, например, как согласованность (consistency), доступность (availability) или идемпотентность (idempotency).

В данном посте я собираюсь рассказать про несколько концепций, которые мне потребовалось изучить и применить на практике при построении крупномасштабной высокодоступной распределённой системы платежей, которая сегодня работает в Uber. Это система с нагрузкой до нескольких тысяч запросов в секунду, в которой критическая функциональность платежей должна работать корректно даже в тех случаях, когда перестают работать отдельные части системы.

Полный ли это список? Скорее всего, нет. Однако, если бы лично я сам узнал про эти концепции раньше, это сделало бы мою жизнь гораздо проще.

Итак, давайте приступим к нашему погружению в SLA, согласованность, долговечность данных, сохранность сообщений, идемпотентность и некоторые другие вещи, которые мне потребовалось выучить на своей новой работе.
Читать полностью »
Предисловие

Недавно прочитал очередную статью из серии: "мы лучше двухфазного коммита". Здесь я не буду анализировать содержания этой статьи (хотя, подумываю о том, чтобы дать развернутый анализ). Задача моего опуса — предложить самый эффективный вариант распределенного коммита с точки зрения временных задержек. Конечно, такой коммит дается высокой ценой. Однако цель — дать оценку и показать, что двухфазный коммит не является тормозным, как многие считают.

Стоит также отметить, что здесь не будет натурных экспериментов и фейковых сравнений. Будут просто даны алгоритмы и теоретический анализ. При желании, можно самостоятельно реализовать и проверить на практике. Конечно, было бы куда лучше, чтобы это было описано в текущей статье, но все упирается в свободное время и мотивацию. На мой взгляд, описать алгоритмы более важно, чем привести графики, т.к. графики по алгоритмам может нарисовать почти каждый, обратное же не верно.

Читать полностью »

image

На момент появления в Apache Software Foundation проекта Ignite он позиционировался как чистое in-memory-решение: распределенный кэш, поднимающий в память данные из традиционной СУБД, чтобы выиграть во времени доступа. Но уже в релизе 2.1 появился модуль встроенной персистентности (Native Persistence), который позволяет классифицировать Ignite как полноценную распределенную базу данных. С тех пор Ignite перестал зависеть от внешних систем обеспечения персистентного хранения данных, и вязанка граблей конфигурации и администрирования, на которые не раз наступали пользователи, исчезла.

Однако persistent-режим порождает свои сценарии и новые вопросы. Как предотвратить неразрешимые конфликты данных в ситуации split-brain? Можем ли мы отказаться от перебалансировки партиций, если выход узла теперь не означает, что данные на нем потеряны? Как автоматизировать дополнительные действия вроде активации кластера? BaselineTopology нам в помощь.

Читать полностью »

GoTo в ИТМО: Ботали неделю. Порвали 2 баяна - 1

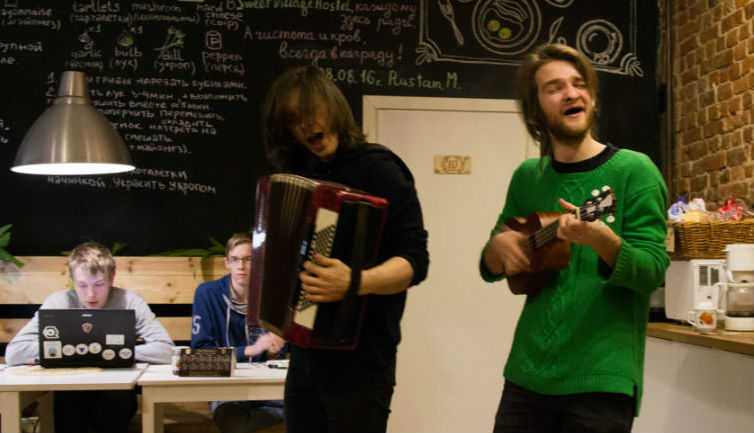
Совсем недавно закончилась очередная школа GoTo в СПб. В отличие от прошлой осени, в этот раз Питер порадовал нас большим количеством солнечных и теплых ноябрьских дней, их было целых два. В один из этих дней боевые единицы из юных и не очень программистов отправились добывать код: поцеловать незнакомых петербуржских девушек, пройти кастинг в Мариинку на эскалаторе, накормить Олега Георгиевича кровью невинного программиста и запечатлить лик Наполеона между ног коня.
В остальные дни мы по старинке делали мы не менее увлекательные проекты по биоинформатике, машинному обучению, распределенным системам и гоняли чаи на кухне с разговорами о прекрасном. Отчет ИТМО можно прочесть здесь.
Не возьмемся судить о том, что читателю интереснее, обо всем по порядку под катом.
Читать полностью »

Библиотека для синхронизации состояния - 1

Так случилось, что на одном проекте потребовалось реформировать способ обмена данными между различными процессами. Исторически сложившаяся схема была довольно неприглядна. Один процесс периодически перезаписывал свои текущие настройки в виде XML-файла. Второй вычитывал этот файл раз в секунду, проверяя, что в нём поменялось с прошлого раза. Изменения файла вычислялись через множество сравнений текущего и прошлого его состояний, порождая некоторую цепочку действий. Читающий процесс писал в свою очередь другой XML-файл, который читался третьим процессом и т.п. Самое печальное то, что данная схема требовала громоздкого, из раза в раз повторяющегося кода сравнений, который наслаивался при добавлении новых данных.

Читать полностью »

Замена маршрутизатора:

Производитель A: 10% сломано
Производитель B: 10% сломано
P(одновременно A и B сломаны):
10% × 10% = 1%

Замена маршрутизатора (или прошивки) почти всегда решает проблему.

Добавление усилителя Wi-Fi:

Маршрутизатор A: 90% работает
Маршрутизатор B: 90% работает
P(одновременно A и B работают):
90% × 90% = 81%

Дополнительный маршрутизатор почти всегда ухудшает ситуацию.

Все беспроводные сети, будь то LTE или mesh-сети, рано или поздно падают, но я могу поставить на то, что ваша сеть Wi-Fi менее надёжная, чем телефонное соединение LTE. На конференции Battlemesh v10 мы все сидели в комнате с десятками экспериментальных неправильно сконфигурированных маршрутизаторов Wi-Fi с открытыми сетями, которые могут дать выход в Интернет, а могут и не дать. Из-за чего сеть бывает надёжной или ненадёжной?

После нескольких лет возни с этими технологиями (в окружении кучи инженеров, работающих над другими проблемами распределённых систем, которые, как выяснилось, обладают теми же ограничениями), я думаю, что могу сделать выводы. Распределённые системы более надёжны, если вы можете получить сервис от одного узла ИЛИ от другого. Они становятся менее надёжными, если сервис зависит от одного узла И от другого. Числа сочетаются мультипликативно, так что чем больше у вас узлов, тем быстрее отвалится сервис.
Читать полностью »

Сегодня мы дадим ответ на простой вопрос: "Как работает распределённое обучение (в контексте MXNet)?"

Все примеры кода протестированные на MXNet v0.10.0 и могут не работать (или работать по-другому) в других версиях, однако полагаю, что общие концепции будут неизменимы еще долго.

Ну и последнее перед тем, как мы перейдем к основной части, я хочу выразить благодарность за помощь в написании статьи моим коллегам, без которых эта статья не была бы возможной:

  • Madan Jampani;
  • Suneel Marthi;

Еще хотел бы порекомендовать поднять машинку с DLAMI и выполнить все примеры из статьи самостоятельно, тем более, что они достаточно простые. Для выполнения кода вполне себе подойдет бесплатная машинка на AWS.

С преамбулой окончено, лезем под кат...

Читать полностью »

Обзор возможностей библиотеки Apache Curator для Apache Zookeeper - 1

По долгу работы мне приходится сталкиваться с проектированием и разработкой распределенных приложений. Такие приложения часто используют различные средства межпроцессного взаимодействия для организации взаимодействия компонентов. Особые сложности возникают в процессе реализации алгоритмов, обрабатывающих связанные данные распределенно. Для поддержки таких задач используются специализированные системы распределенной координации. Самым популярным и широко используемым продуктом является Apache Zookeeper.Читать полностью »

В предыдущей публикации мы рассказали про историю создания RedPine, попытавшись в укрупненном масштабе показать, зачем мы когда-то избрали путь разработки собственной системы мониторинга, диспетчеризации и управления и какие возможности нам стали доступны благодаря этому.

5 ключевых преимуществ систем мониторинга, диспетчеризации и управления RedPine - 1

Мы выделили 5 ключевых преимуществ, которые позволяют реализовать все те возможности, которыми должна обладать современная система мониторинга, диспетчеризации и управления.

  • Широкий функционал и гибкость
  • Простота установки
  • Гибкое ПО для обеспечения функционала
  • В зоне доступа – невысокие требования к уровню сигнала
  • Универсальность — возможность использовать на различном оборудовании

В новой статье мы подробнее расскажем о каждом из этих 5 ключевых моментов и объясним, почему они являются действительно ключевыми, и почему мы называем их преимуществами.

Читать полностью »

В предыдущей статье — часть 1, обзорная — я рассказал о том, зачем нужны распределенные структуры данных (далее — РСД) и разобрал несколько вариантов, предлагаемых распределенным кешем Apache Ignite.

Сегодня же я хочу рассказать о подробностях реализации конкретных РСД, а также провести небольшой ликбез по распределенным кешам.

Итак:

Распределенные структуры данных (часть 2, как это сделано) - 1

Читать полностью »


https://ajax.googleapis.com/ajax/libs/jquery/3.4.1/jquery.min.js